






Comment fonctionne l'algorithme HNSW, comment régler M et ef_search, combien de mémoire prévoir et comment sécuriser un index vectoriel partagé dans un RAG en 2026.
HNSW (Hierarchical Navigable Small World) est l'algorithme d'indexation qui permet à la plupart des bases vectorielles de retrouver, en une fraction du temps d'une comparaison exhaustive, les passages les plus proches d'une question parmi des millions d'embeddings. Décrit par Yury Malkov et Dmitry Yashunin en 2016, il organise les vecteurs en un graphe à plusieurs couches que l'on parcourt du général au particulier, un peu comme on zoome sur une carte. En 2026, on le retrouve dans pgvector, Qdrant, Weaviate, Milvus, Lucene ou FAISS, et donc au cœur de la plupart des pipelines de génération augmentée par récupération (RAG). Comprendre son fonctionnement n'est pas qu'une affaire de performance : les paramètres M, ef_construction et ef_search déterminent ce que le modèle de langage verra, et la façon dont l'index est partagé, filtré et purgé conditionne la confidentialité des documents. Voici comment il fonctionne, comment le régler, combien de mémoire prévoir et comment le sécuriser.
Résumé exécutif : HNSW est un index de recherche approximative des plus proches voisins qui échange un peu d'exactitude contre une forte accélération des requêtes. Trois paramètres pilotent ce compromis : M (connexions par nœud), ef_construction (qualité du graphe) et ef_search (rappel à la requête). Dans un RAG, l'index porte aussi des données sensibles, doit respecter les droits de chaque utilisateur et doit pouvoir oublier un document sur demande. Mesurer le rappel, isoler les locataires et maîtriser la suppression sont les trois chantiers prioritaires.
Points clés de cet article :
- Conserver les valeurs par défaut de M et ef_construction tant qu'un jeu de questions de référence n'a pas montré un rappel insuffisant.
- Régler ef_search par requête ou par transaction, en le bornant côté serveur pour éviter les abus de ressources.
- Isoler chaque locataire ou niveau de confidentialité par partition ou par index distinct, et appliquer le filtre d'autorisation dans le service de recherche.
- Prévoir une procédure d'effacement complète : suppression, nettoyage ou reconstruction de l'index, purge des sauvegardes et des caches.
- Superviser le rappel@k, la latence et la taille de l'index, et reconstruire l'index à chaque changement de modèle d'embedding.
HNSW (hierarchical navigable small world) : définition de l'algorithme
HNSW (Hierarchical Navigable Small World) : structure d'index de recherche approximative des plus proches voisins (ANN) qui organise des vecteurs en graphes de proximité superposés, permettant de trouver les voisins d'une requête en un nombre d'étapes qui croît de façon logarithmique avec la taille de la collection.
L'article fondateur, « Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs », a été déposé sur arXiv en mars 2016 puis révisé jusqu'en août 2018. Il prolonge les graphes NSW (Navigable Small World) étudiés auparavant, en séparant les liens selon leur échelle de distance : les liens longs dans les couches hautes, les liens courts en bas.
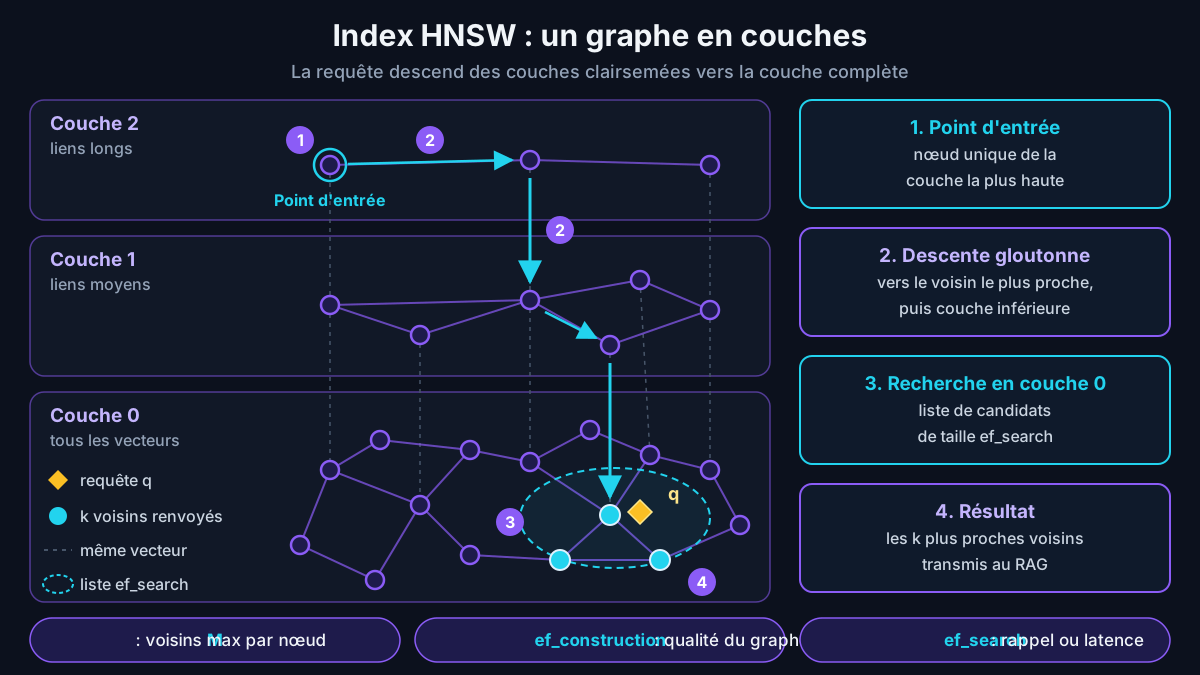
Le principe rappelle celui d'une skip list, la liste chaînée à plusieurs niveaux utilisée en algorithmique. Chaque vecteur reçoit un niveau maximal tiré au hasard selon une loi qui décroît exponentiellement. La couche 0 contient donc tous les éléments, la couche 1 une fraction d'entre eux, la couche 2 une fraction encore plus petite, et ainsi de suite jusqu'au point d'entrée unique.
HNSW est un algorithme approximatif : il ne garantit pas de renvoyer les vrais plus proches voisins, seulement des voisins très proches dans la grande majorité des cas. Cette perte est mesurée par le rappel (recall), c'est-à-dire la proportion des vrais voisins effectivement retrouvés. Le rappel d'un index HNSW n'est jamais garanti à 100 % : il se règle, se mesure et se surveille.
Ce compromis explique sa popularité : les auteurs montraient déjà qu'il dépassait nettement les index vectoriels open source de l'époque, et il est devenu le choix par défaut de nombreux moteurs. Autre atout : il n'exige aucune phase d'apprentissage préalable, contrairement aux index à partitionnement de type IVF (Inverted File).
Pourquoi un index HNSW est indispensable à un RAG
Un système RAG (Retrieval-Augmented Generation) transforme la question de l'utilisateur en vecteur, cherche les passages dont les vecteurs sont les plus proches, puis transmet ces passages au modèle de langage comme contexte. Pour bien saisir cette étape, le guide Embeddings IA : comprendre et implémenter le cœur du RAG détaille comment un texte devient un vecteur de plusieurs centaines de dimensions.
Sans index, la base compare la requête à chaque vecteur stocké. Le coût croît linéairement avec le nombre de passages et leur dimension : un million de passages de 1 024 dimensions représentent environ un milliard de multiplications par question. Cette recherche exacte reste pertinente pour quelques dizaines de milliers de vecteurs, mais devient vite prohibitive lorsque le corpus et le nombre d'utilisateurs augmentent.
La documentation de pgvector le rappelle : sans index, l'extension effectue une recherche exacte au rappel parfait, et un index approximatif échange un peu de rappel contre de la vitesse. Les résultats d'une même requête peuvent donc changer après l'indexation, ce qui surprend souvent les équipes de test.
Dans un RAG, un passage manqué par l'index n'est pas une simple ligne absente d'un résultat : c'est un contexte que le modèle ne verra jamais. La réponse sera incomplète, ou le modèle comblera le vide par une invention. Le rappel de l'index HNSW pèse donc autant sur la qualité finale que le découpage des documents, sujet traité dans notre article sur les stratégies de chunking RAG.
Comment se construit un index HNSW : couches et voisins
Un index HNSW est un ensemble de graphes de proximité emboîtés. Chaque nœud est un vecteur, chaque arête relie deux vecteurs proches. Les couches hautes, très clairsemées, servent d'autoroutes pour traverser rapidement l'espace ; la couche 0, complète et dense, sert à affiner la recherche localement. Deux mécanismes façonnent ce graphe : l'insertion incrémentale et l'heuristique de choix des voisins.
Construction incrémentale du graphe
Chaque nouveau vecteur reçoit d'abord un niveau maximal aléatoire. L'algorithme part du point d'entrée, situé dans la couche la plus haute, et descend de couche en couche en se déplaçant à chaque fois vers le nœud le plus proche. Arrivé à son propre niveau, il cherche une liste de candidats de taille ef_construction, puis relie le nouvel élément à au plus M d'entre eux, par des liens bidirectionnels.
Lorsqu'un nœud existant dépasse son nombre maximal de connexions, ses liens sont élagués. L'article original recommande d'autoriser deux fois plus de voisins dans la couche 0 que dans les couches supérieures, car c'est là que se joue la précision finale. Cette construction incrémentale permet d'ajouter des vecteurs à tout moment sans reconstruire l'index, ce qui convient aux bases documentaires vivantes.
Heuristique de sélection des voisins
Relier chaque nœud uniquement à ses voisins les plus proches crée des grappes isolées lorsque les données sont regroupées par thèmes, ce qui est typique des corpus d'entreprise. L'heuristique de HNSW privilégie des voisins orientés dans des directions variées, ce qui préserve des chemins entre grappes. Selon les auteurs, ce choix améliore nettement les performances à haut rappel et sur des données fortement regroupées.
Comment une requête parcourt le graphe HNSW
Une requête parcourt l'index HNSW en partant du point d'entrée, situé dans la couche la plus haute. Dans chaque couche haute, l'algorithme avance vers le voisin le plus proche de la requête jusqu'à ne plus pouvoir s'améliorer, puis descend d'un niveau. Dans la couche 0, il maintient une liste dynamique de candidats de taille ef_search, explore leurs voisins, et conserve les meilleurs. Les k plus proches de cette liste constituent le résultat transmis au pipeline de génération augmentée (RAG).
Le coût d'une recherche dépend donc surtout du nombre de nœuds visités, et non de la taille totale de la collection. C'est ce qui donne à HNSW sa complexité quasi logarithmique : doubler le corpus n'ajoute que quelques étapes de descente. En contrepartie, une liste ef_search trop courte peut enfermer la recherche dans une zone locale et manquer de vrais voisins.
Régler un index HNSW : M, ef_construction et ef_search
Trois paramètres gouvernent le compromis entre rappel, vitesse et mémoire. Deux sont fixés à la construction et figent la structure du graphe : M et ef_construction. Le troisième, ef_search, se règle au moment de la requête et peut varier d'un appel à l'autre. Les noms changent selon les moteurs, mais les rôles restent identiques, comme le montre le tableau suivant.
| Paramètre | Rôle | Défaut pgvector | Défaut hnswlib | Effet d'une hausse |
|---|---|---|---|---|
| M (m) | Nombre maximal de connexions par nœud et par couche | 16 | 16 | Rappel en hausse, mémoire et temps de construction en hausse |
| ef_construction | Taille de la liste de candidats lors de l'insertion | 64 | 200 | Graphe de meilleure qualité, construction et insertions plus lentes |
| ef_search (ef) | Taille de la liste de candidats lors de la requête | 40 | À fixer explicitement | Rappel en hausse, latence en hausse |
| k (LIMIT) | Nombre de voisins renvoyés | Défini par la requête | Défini par la requête | Doit rester inférieur ou égal à ef_search |
La documentation des paramètres de la bibliothèque de référence, le fichier ALGO_PARAMS.md de hnswlib, situe une plage raisonnable de M entre 2 et 100, et juge la plage 12 à 48 adaptée à la plupart des usages. Les embeddings de grande dimension visant un rappel élevé peuvent nécessiter un M de 48 à 64. Chaque unité de M coûte environ 8 à 10 octets de liens par élément stocké.
Pour ef_construction, la même source propose un test simple : mesurer le rappel d'une recherche des M plus proches voisins avec ef égal à ef_construction. Si ce rappel reste sous 0,9, le graphe peut encore être amélioré. Au-delà d'un certain seuil, augmenter ef_construction n'apporte plus rien, sinon une construction plus longue. Elle suggère aussi, lorsque l'on modifie M, d'ajuster ef et ef_construction en considérant le produit M × ef_construction comme à peu près constant.
ef_search est le levier quotidien. Dans pgvector, il se fixe pour une transaction avec SET LOCAL hnsw.ef_search, ce qui permet d'adapter le rappel à chaque cas d'usage. Attention : le nombre de résultats est plafonné par ef_search. Avec la valeur par défaut de 40, une requête demandant 50 passages n'en renverra pas plus de 40, même sans filtre.
Conseil d'expert : constituez un jeu de 200 à 500 questions réelles issues des journaux de l'assistant, calculez leurs vrais voisins par recherche exacte, puis faites varier uniquement ef_search en traçant la courbe rappel@k contre latence. Ne touchez à M et ef_construction que si cette courbe plafonne sous votre objectif, et reconstruisez alors l'index sur une copie avant toute bascule.
HNSW face à IVFFlat, à la quantification et aux index sur disque
HNSW n'est pas le seul index vectoriel. Son concurrent historique, IVFFlat (Inverted File sans compression), découpe l'espace en listes par un algorithme k-means et ne parcourt que les listes proches de la requête. Selon pgvector, IVFFlat se construit plus vite et consomme moins de mémoire, mais offre un moins bon compromis entre vitesse et rappel. Il exige aussi des données représentatives avant sa création, alors qu'un index HNSW peut être créé sur une table vide.
La quantification réduit la place occupée par chaque vecteur : demi-précision (16 bits), octets (8 bits) ou binaire (1 bit par dimension). Elle se combine souvent avec HNSW : le graphe est construit sur les vecteurs compressés, puis les meilleurs candidats sont reclassés avec les vecteurs originaux. pgvector documente cette approche de quantification binaire suivie d'un reclassement pour garder l'index en mémoire à grande échelle.
Lorsque la mémoire vive ne suffit plus, les index de graphe sur disque prennent le relais. DiskANN, issu de Microsoft Research, conserve l'essentiel du graphe sur SSD et ne garde qu'une version compressée en mémoire. Certains moteurs proposent un mode équivalent, qui combine quantification forte et reclassement à partir du disque, au prix d'une latence un peu plus élevée.
| Critère | Recherche exacte | HNSW | IVFFlat | HNSW + quantification |
|---|---|---|---|---|
| Rappel | Parfait | Élevé, réglable | Moyen à élevé selon les sondes | Élevé avec reclassement |
| Latence à grande échelle | Mauvaise | Très bonne | Bonne | Très bonne |
| Mémoire | Vecteurs seuls | Vecteurs + graphe | Vecteurs + centroïdes | Réduite |
| Construction | Aucune | Lente | Rapide, après chargement | Plus rapide que HNSW complet |
| Ajouts fréquents | Sans effet | Bien supportés | Dérive possible des listes | Bien supportés |
| Cas d'usage typique | Petits corpus, vérité terrain | RAG généraliste | Corpus stable, mémoire limitée | Très gros corpus |
Le choix d'index dépend aussi du moteur retenu, de ses options de filtrage et de ses fonctions de sécurité. Avant tout arbitrage, notre comparatif complet des bases de données vectorielles recense les index proposés par les principaux moteurs et leurs limites connues.
Mémoire et coûts d'exploitation d'un index HNSW
La mémoire d'un index HNSW se répartit entre les vecteurs eux-mêmes et les liens du graphe. Les vecteurs dominent presque toujours. Dans pgvector, un vecteur en simple précision occupe 4 octets par dimension plus 8 octets d'en-tête : un embedding de 1 536 dimensions pèse donc 6 152 octets, contre 128 à 160 octets de liens environ pour M égal à 16.
Ordre de grandeur sourcé : la documentation OpenSearch sur les vecteurs optimisés en mémoire (version en ligne consultée le 2 novembre 2026) estime la mémoire d'un graphe HNSW à 1,1 × (2 × dimension + 8 × m) octets par vecteur en demi-précision. Pour 1 million de vecteurs de 256 dimensions avec m = 16, cela représente environ 0,656 Go, et environ 0,39 Go avec des vecteurs d'un octet par dimension.
En appliquant la même formule à des vecteurs en simple précision (4 octets par dimension), un million d'embeddings de 1 024 dimensions avec m égal à 16 demandent environ 4,6 Go. Ce calcul ne couvre que l'index : il faut y ajouter les répliques, la marge du système, le cache du moteur et la croissance prévisible du corpus sur la durée du projet.
La construction est l'autre coût majeur. pgvector indique que l'index se construit nettement plus vite lorsque le graphe tient dans maintenance_work_mem, et affiche un avertissement dès que ce n'est plus le cas. Le nombre de processus parallèles de maintenance accélère aussi la création. Il faut néanmoins éviter de fixer une valeur qui épuiserait la mémoire du serveur.
Un index peut déborder de la mémoire vive, mais ses performances en pâtissent. Les leviers de réduction sont connus : type halfvec pour diviser le stockage par deux, quantification binaire avec reclassement, ou réduction de dimension lorsque le modèle d'embedding le permet. Chaque option doit être validée par une nouvelle mesure du rappel.
Mettre en œuvre un index HNSW avec pgvector
PostgreSQL avec l'extension pgvector est souvent le point de départ le plus simple : les vecteurs restent à côté des données métier, avec les transactions, la réplication et les sauvegardes déjà maîtrisées. Pour comparer cette option aux bases spécialisées, consultez notre guide pour choisir sa base de données IA. La démarche ci-dessous suit les recommandations de la documentation officielle.
Environnement de test : maquette de référence pour reproduire les exemples : machine virtuelle Debian 13 (8 vCPU, 32 Go de RAM) isolée de la production, PostgreSQL 18 avec pgvector 0.8.7, Python 3.12 avec hnswlib, et un corpus de documents publics vectorisés par un modèle d'embedding open source de 1 024 dimensions. Aucun résultat chiffré n'est publié ici : latence et rappel dépendent du matériel, du modèle et du corpus, et se mesurent sur vos propres données.
- Choisir l'opérateur de distance cohérent avec le modèle d'embedding : cosinus par défaut, produit scalaire si les vecteurs sont normalisés à une longueur de 1.
- Charger les données en masse avec
COPY, puis créer l'index, ce qui est plus rapide qu'une indexation au fil de l'eau. - Augmenter temporairement
maintenance_work_memet créer l'index avecCREATE INDEX CONCURRENTLYpour ne pas bloquer les écritures. - Vérifier avec
EXPLAIN (ANALYZE, BUFFERS)que la requête utilise bien l'index. - Mesurer le rappel en comparant les résultats approximatifs à ceux d'une recherche exacte.
-- 1. Table partitionnée par locataire : un index HNSW par partition
CREATE TABLE chunks (
  id             bigserial,
  tenant_id      int  NOT NULL,
  doc_id         uuid NOT NULL,
  classification text NOT NULL,
  embedding      vector(1024) NOT NULL,
  PRIMARY KEY (tenant_id, id)
) PARTITION BY LIST (tenant_id);
CREATE TABLE chunks_t42 PARTITION OF chunks FOR VALUES IN (42);

-- 2. Construction après chargement (COPY), sans bloquer les écritures
SET maintenance_work_mem = '4GB';
CREATE INDEX CONCURRENTLY chunks_t42_hnsw
  ON chunks_t42 USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);

-- 3. Requête RAG : paramètres bornés et limités à la transaction
BEGIN;
SET LOCAL hnsw.ef_search = 100;
SET LOCAL hnsw.iterative_scan = relaxed_order;
SET LOCAL statement_timeout = '2s';
SELECT id, doc_id
FROM chunks
WHERE tenant_id = 42                       -- issu de la session, jamais du prompt
  AND classification = ANY (ARRAY['public', 'interne'])
ORDER BY embedding <=> (SELECT q FROM requetes_test WHERE id = 1)
LIMIT 8;
COMMIT;

-- 4. Référence exacte pour mesurer le rappel@8
BEGIN;
SET LOCAL enable_indexscan = off;
SELECT id FROM chunks
WHERE tenant_id = 42
  AND classification = ANY (ARRAY['public', 'interne'])
ORDER BY embedding <=> (SELECT q FROM requetes_test WHERE id = 1)
LIMIT 8;
COMMIT;

-- 5. Taille de l'index à superviser
SELECT pg_size_pretty(pg_relation_size('chunks_t42_hnsw'));
Pièges courants d'un index HNSW sous pgvector
Quelques pièges reviennent souvent. L'index n'est utilisé que si la requête comporte un ORDER BY sur l'opérateur de distance, en ordre croissant, et une clause LIMIT : trier sur « 1 − distance » en ordre décroissant le désactive. Les valeurs NULL ne sont pas indexées, pas plus que les vecteurs entièrement à zéro en distance cosinus. Enfin, l'ordre relâché des parcours itératifs peut légèrement inverser deux résultats proches.
Retour terrain : Cas typique rencontré en mission — sur un RAG adossé à pgvector, l'index HNSW est construit avec les paramètres par défaut et une mémoire de maintenance insuffisante, puis jamais comparé à une recherche exacte. Avec un filtre de classification sélectif, le post-filtrage renvoie moins de passages que demandé, sans alerte. Je recommande des requêtes de référence, une mesure du rappel après chaque réglage d'ef_search et l'activation du parcours itératif.
HNSW RAG : filtrage, multi-locataires et contrôle d'accès
Dans un RAG (génération augmentée par récupération) d'entreprise, presque chaque recherche s'accompagne d'un filtre : locataire, direction, niveau de classification, langue ou date de validité. Or le graphe HNSW ignore tout des métadonnées. Il relie des vecteurs proches, quel que soit leur propriétaire. La manière dont le filtre est appliqué détermine à la fois la qualité des réponses et l'étanchéité entre les populations d'utilisateurs.
Avec un filtrage appliqué après le parcours de l'index, les résultats fondent. La documentation de pgvector donne un exemple parlant : si une condition ne retient que 10 % des lignes, la valeur par défaut d'ef_search de 40 ne laisse en moyenne que 4 résultats. Depuis la version 0.8.0, les parcours itératifs poursuivent l'exploration jusqu'à trouver assez de résultats, dans la limite de hnsw.max_scan_tuples, fixé par défaut à 20 000.
D'autres stratégies existent. Un index classique sur la colonne de filtre permet une recherche exacte rapide lorsque la condition est très sélective. Un index HNSW partiel, limité à une valeur, convient lorsque le filtre ne prend que quelques valeurs. Le partitionnement s'impose lorsque les valeurs sont nombreuses. Certaines bibliothèques, comme hnswlib, appliquent même le filtre pendant le parcours du graphe.
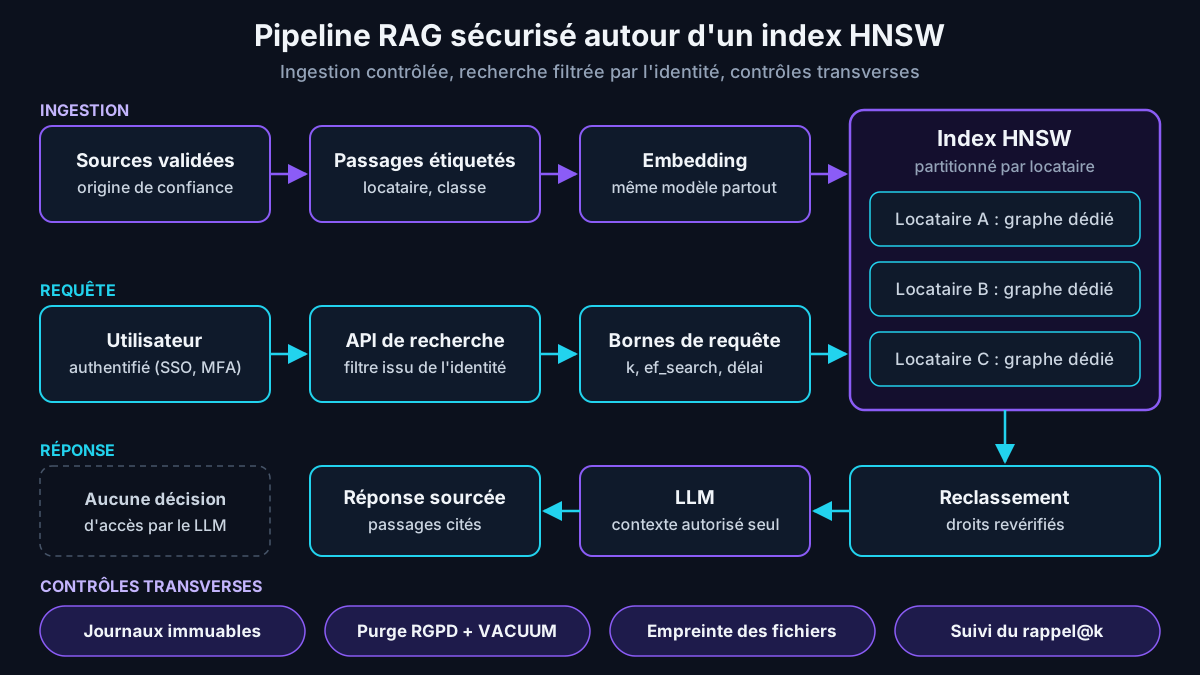
Le cas multi-locataires mérite une attention particulière. pgvector souligne qu'un index approximatif partagé entre locataires laisse les vecteurs de l'un influer sur le rappel et la vitesse des autres, et recommande des partitions par liste ou des tables séparées pour isoler chaque locataire. Cette séparation physique est aussi la meilleure protection contre une fuite de passages d'un client vers un autre.
Le principe de sécurité est simple : le filtre d'autorisation doit être calculé par le service de recherche à partir de l'identité authentifiée, jamais à partir du texte de la question ni par le modèle de langage. Le LLM (grand modèle de langage) ne doit recevoir que des passages que l'utilisateur aurait le droit de lire directement dans la source d'origine.
Menaces sur l'index vectoriel : la grille OWASP LLM08
Avertissement : cette section décrit des catégories de menaces pour aider à les prévenir et à les détecter. Tout test de robustesse d'un système RAG doit être réalisé sur un périmètre dont vous êtes responsable ou avec l'autorisation écrite de son propriétaire, dans un environnement isolé.
L'OWASP a consacré une entrée spécifique aux faiblesses des vecteurs et des embeddings dans son classement des risques des applications à base de LLM (grands modèles de langage) : LLM08:2025 Vector and Embedding Weaknesses. Elle couvre les accès non autorisés, les fuites entre contextes en environnement mutualisé, l'inversion d'embeddings, l'empoisonnement des données et l'altération du comportement du modèle.
Les menaces qui touchent directement un index HNSW et les mesures correspondantes peuvent se résumer ainsi :
- Fuite entre locataires ou entre niveaux de confidentialité : partitions ou index distincts, filtre d'autorisation appliqué côté serveur, tests automatisés vérifiant qu'un compte ne retrouve jamais un passage d'un autre périmètre.
- Inversion d'embeddings : des recherches montrent qu'un vecteur peut permettre de reconstituer une part importante du texte source ; les vecteurs et les fichiers d'index se protègent donc comme les documents eux-mêmes (chiffrement au repos, droits restreints, sauvegardes maîtrisées).
- Empoisonnement du corpus : validation des documents avant ingestion, sources de confiance uniquement, détection du texte masqué, comme le recommande l'OWASP.
- Épuisement des ressources : valeurs maximales imposées à k, à ef_search et au nombre de nœuds visités, délai d'exécution par requête et quotas par utilisateur.
- Fichiers d'index piégés : ne jamais désérialiser un index reçu d'une source non maîtrisée, car la sérialisation Python par pickle, prise en charge par hnswlib, peut exécuter du code au chargement.
L'empoisonnement mérite d'être détaillé, car un document conçu pour être proche de nombreuses questions peut s'imposer dans les résultats sans paraître suspect. Notre analyse des attaques RAG par empoisonnement vectoriel présente ces scénarios et les signaux permettant de les détecter, notamment la surreprésentation anormale d'un même passage dans les résultats.
Recommandations ANSSI et journalisation appliquées à l'index HNSW
Côté français, le guide de l'Agence nationale de la sécurité des systèmes d'information (ANSSI) Recommandations de sécurité pour un système d'IA générative (ANSSI-PA-102, avril 2024) identifie la base de données vectorielle comme un composant de l'architecture à part entière. Il demande de cartographier tous les jeux de données, base vectorielle comprise, et de gérer le besoin d'en connaître sur les données additionnelles d'un système RAG par des droits d'accès.
Le même guide recommande d'utiliser des formats de fichiers sûrs, de proscrire le format pickle pour les modèles et de contrôler régulièrement l'intégrité des fichiers du système d'IA. Appliquée à un index HNSW, cette logique impose de calculer une empreinte de chaque fichier d'index produit, de la vérifier au chargement et de stocker les index dans un emplacement accessible au seul service de recherche.
La journalisation complète le dispositif. L'OWASP (Open Worldwide Application Security Project) recommande de conserver des journaux immuables des activités de récupération. Pour chaque recherche, il est utile de tracer l'identité, les filtres effectivement appliqués, les identifiants des passages renvoyés et les valeurs de k et d'ef_search, sans recopier le texte des documents dans les journaux. Ces traces alimentent ensuite les règles de détection du centre opérationnel de sécurité (SOC).
Retour terrain : Cas typique rencontré en mission — un assistant RAG interne interroge un index HNSW unique mêlant plusieurs filiales et niveaux de sensibilité, le cloisonnement reposant sur une consigne du prompt. Une question posée depuis un compte standard fait remonter une note réservée à la direction. Correctifs retenus : filtrage par droits appliqué dans la base selon l'identité de session, partitions par entité et journalisation des passages renvoyés.
Suppression des vecteurs et RGPD : ce que l'index HNSW conserve
Supprimer un nœud d'un graphe HNSW est délicat : retirer un vecteur casse les chemins qui passaient par lui. La plupart des implémentations se contentent donc de le marquer. Dans hnswlib, la fonction mark_deleted exclut l'élément des résultats, mais une fonction inverse permet de l'annuler, preuve que le vecteur reste stocké. Il ne disparaît qu'au remplacement de son emplacement ou à la reconstruction.
Un vecteur marqué comme supprimé reste présent dans l'index, en mémoire comme dans les fichiers sauvegardés. Dans PostgreSQL, un DELETE laisse des lignes mortes jusqu'au passage de VACUUM, qui peut être long sur un index HNSW ; pgvector conseille d'ailleurs de reconstruire l'index avec REINDEX INDEX CONCURRENTLY avant de lancer le nettoyage.
Ces mécanismes comptent pour le Règlement général sur la protection des données (RGPD). Un embedding calculé à partir d'un texte contenant des données personnelles reste lié à ces données, d'autant que l'inversion d'embeddings est documentée. Une demande d'effacement fondée sur l'article 17 doit donc couvrir le document source, ses passages, leurs vecteurs, les index qui les contiennent, les caches de réponses et les sauvegardes, selon une durée de rétention annoncée.
En pratique, la procédure tient en quelques étapes : tracer pour chaque document la liste des identifiants de passages et de vecteurs dérivés, supprimer ces lignes, déclencher le nettoyage ou la reconstruction de l'index, invalider les caches, puis consigner l'opération. Une reconstruction planifiée, par exemple mensuelle, limite la durée de survie des traces physiques.
Mesurer le rappel et superviser un index HNSW en production
Le rappel@k mesure la proportion des k vrais plus proches voisins retrouvés par l'index. Il se calcule en comparant, pour un jeu de questions de référence, les résultats de l'index à ceux d'une recherche exacte. pgvector propose précisément cette méthode, en désactivant temporairement les parcours d'index dans une transaction pour obtenir la vérité terrain.
Un tableau de bord minimal d'exploitation pour un index HNSW en production comprend les indicateurs suivants :
- le rappel@k hebdomadaire sur un jeu de questions de référence stable, avec une alerte en cas de baisse ;
- la latence au 95e et au 99e centile, par cas d'usage et par locataire ;
- la taille de l'index et la mémoire disponible sur chaque nœud ou réplique ;
- le volume de lignes mortes et la date du dernier nettoyage ou de la dernière reconstruction ;
- la part des requêtes renvoyant moins de k résultats, symptôme d'un filtre trop sélectif.
Le changement de modèle d'embedding est un événement majeur. Les vecteurs produits par deux modèles différents ne sont pas comparables, même à dimension égale. Il faut donc recalculer tous les embeddings, reconstruire l'index et refaire la mesure du rappel. Le guide pratique de l'embedding vectoriel en Python détaille la génération et la vérification des vecteurs avant indexation.
Enfin, la supervision doit rester reliée à la sécurité. Une hausse brutale de la latence peut signaler des requêtes abusives ; un passage qui apparaît soudain dans une grande part des résultats peut trahir un empoisonnement ; une augmentation des requêtes vides peut révéler un filtre d'autorisation mal configuré. Ces signaux méritent des règles d'alerte dédiées.
À lire aussi : les menaces IA référencées par MITRE ATLAS.
Questions fréquentes
Qu'est-ce que l'algorithme HNSW en termes simples ?
HNSW est une méthode pour retrouver rapidement les vecteurs les plus proches d'une requête sans les comparer tous. Il range les vecteurs dans plusieurs graphes superposés : les couches hautes contiennent peu d'éléments reliés par de longs sauts, la couche du bas contient tous les éléments reliés à leurs voisins proches. Une recherche commence en haut, se rapproche de la cible à grands pas, puis descend pour affiner localement. Le résultat est approximatif mais très proche du résultat exact, pour un coût qui augmente peu avec la taille de la collection. C'est l'index par défaut de nombreuses bases vectorielles en 2026.
Quelle est la différence entre un index HNSW et un index IVFFlat ?
Un index HNSW repose sur un graphe de voisinage en couches, tandis qu'IVFFlat découpe l'espace en listes à l'aide d'un algorithme k-means et ne parcourt que les listes proches de la requête. D'après la documentation de pgvector, HNSW offre un meilleur compromis entre vitesse et rappel, mais se construit plus lentement et consomme davantage de mémoire. IVFFlat nécessite des données représentatives avant sa création, car il doit calculer ses centroïdes, alors qu'un index HNSW peut être créé sur une table vide. Pour un RAG dont le corpus évolue souvent, HNSW est généralement le choix par défaut ; IVFFlat reste intéressant quand la mémoire est contrainte.
Quelles valeurs choisir pour M, ef_construction et ef_search ?
Partez des valeurs par défaut de votre moteur, par exemple M égal à 16, ef_construction égal à 64 et ef_search égal à 40 dans pgvector. Mesurez ensuite le rappel@k sur un jeu de questions réelles dont les vrais voisins ont été calculés par recherche exacte. Augmentez d'abord ef_search, qui se règle sans reconstruire l'index, jusqu'à atteindre le rappel visé avec une latence acceptable. Si la courbe plafonne, reconstruisez l'index avec un M plus élevé, dans une plage de 12 à 48 selon la documentation de hnswlib, voire davantage pour des embeddings de grande dimension. Validez chaque changement sur une copie avant de basculer la production.
Pourquoi une requête renvoie-t-elle moins de résultats après la création d'un index HNSW ?
Deux causes principales expliquent ce phénomène. D'abord, le nombre de résultats est plafonné par la taille de la liste de candidats ef_search, fixée à 40 par défaut dans pgvector : une clause LIMIT plus grande ne sera pas satisfaite. Ensuite, les filtres de la clause WHERE sont appliqués après le parcours de l'index, si bien qu'une condition qui ne retient que 10 % des lignes laisse en moyenne 4 résultats. Les lignes mortes non nettoyées réduisent aussi le nombre de résultats. Les solutions consistent à augmenter ef_search, à activer les parcours itératifs disponibles depuis pgvector 0.8.0, ou à partitionner les données selon le filtre.
Peut-on supprimer définitivement un vecteur d'un index HNSW ?
Oui, mais rarement de façon immédiate. Dans la plupart des implémentations, la suppression marque d'abord le vecteur comme effacé : il n'apparaît plus dans les résultats, mais ses données restent stockées dans l'index. Dans hnswlib, l'emplacement n'est libéré que lorsqu'un nouvel élément le remplace ou lors d'une reconstruction. Dans PostgreSQL avec pgvector, il faut attendre le passage de VACUUM, idéalement précédé d'une reconstruction de l'index. Pour répondre à une demande d'effacement au titre du RGPD, il faut donc enchaîner suppression, nettoyage ou reconstruction, invalidation des caches et purge des sauvegardes selon la durée de rétention annoncée, puis conserver une trace de l'opération.
Conclusion
HNSW s'est imposé comme l'index vectoriel de référence parce qu'il offre un excellent compromis entre rappel, vitesse et simplicité d'exploitation. Les paramètres M, ef_construction et ef_search se règlent par la mesure, jamais à l'intuition, sur un jeu de questions représentatif.
Dans un RAG, l'index HNSW mérite pourtant d'être traité comme un composant critique : ses réglages déterminent le contexte fourni au modèle, son partage entre populations peut créer des fuites, et sa gestion des suppressions engage la conformité au RGPD. Mesurer le rappel, isoler les locataires, borner les requêtes et maîtriser le cycle de vie des vecteurs sont les quatre réflexes à adopter. Pour replacer l'index dans l'architecture complète, relisez notre guide de référence sur le RAG (Retrieval-Augmented Generation).
Faire auditer votre RAG et votre base vectorielle
Ayi NEDJIMI accompagne les équipes qui déploient des assistants RAG : revue d'architecture, contrôle de l'isolation des index vectoriels, tests de fuite entre locataires et d'empoisonnement en environnement autorisé, procédure d'effacement conforme au RGPD et plan de supervision.
Demander un audit de votre RAGÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Testez vos connaissances
Mini-quiz de certification lié à cet article — propulsé par CertifExpress
Articles connexes
SLERP : interpolation sphérique, fusion de LLM et sécurité
Comprendre l'interpolation sphérique SLERP, son rôle dans la fusion de deux LLM avec mergekit et les contrôles de sécurité à appliquer avant de déployer un modèle fusionné.
Benchmark LLM novembre 2026 : classement complet des IA
Édition #10 : Gemini 4 Carbon mène l'index v5.0 et l'Arena. Classement complet, prix, débit, modèles ouverts, Mistral et méthodologie, avec chaque source datée.
Benchmark LLM Août 2026 : Kimi K3 prend un classement Arena, la guerre des prix s'ouvre
Édition #8 : Kimi K3 devient le premier modèle à poids ouverts à dominer un classement LMArena. Grok 4.6 et DeepSeek V4 Pro sortent le même jour et déclenchent une guerre des prix.
Sécurisez vos systèmes d'IA & LLM
Red teaming LLM, audit RAG, détection shadow AI, gouvernance des usages IA en entreprise. Expertise technique et réglementaire (EU AI Act).
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Laisser un commentaire