






Comprendre l'interpolation sphérique SLERP, son rôle dans la fusion de deux LLM avec mergekit et les contrôles de sécurité à appliquer avant de déployer un modèle fusionné.
SLERP (Spherical Linear Interpolation, ou interpolation linéaire sphérique) est une méthode de calcul qui produit des points intermédiaires entre deux vecteurs en suivant l'arc de cercle qui les relie plutôt que la ligne droite. Popularisée en 1985 par Ken Shoemake pour animer des rotations 3D décrites par des quaternions, elle sert aujourd'hui à parcourir l'espace latent des modèles génératifs et, surtout, à fusionner deux grands modèles de langage (LLM) sans aucun réentraînement. La bibliothèque open source mergekit, éditée par Arcee, l'expose comme une méthode de fusion prête à l'emploi. Cette simplicité a un revers : le modèle obtenu hérite de tout ce que contiennent ses deux parents, y compris une porte dérobée, un défaut d'alignement ou une licence incompatible. Ce guide détaille la formule, son implémentation réelle et les contrôles de sécurité à appliquer avant de mettre en production un modèle fusionné, en complément de notre dossier sur le fine-tuning de LLM avec LoRA et QLoRA.
Résumé exécutif : SLERP interpole deux vecteurs le long d'un arc de grand cercle, ce qui conserve leur norme et fait progresser l'angle de façon régulière. Appliquée aux poids de deux LLM de même architecture, elle crée un modèle intermédiaire sur un simple processeur ou une carte graphique de 8 Go, sans données d'entraînement. Ce modèle est un nouvel artefact logiciel : sa provenance, ses fichiers, son alignement et sa licence doivent être vérifiés comme ceux de n'importe quel composant tiers. Une chaîne de fusion maîtrisée repose sur des parents épinglés, des formats sûrs, un environnement isolé, des tests comparatifs et une signature finale.
Points clés de cet article :
- Retenir la formule : les coefficients sin((1 − t)Ω)/sin Ω et sin(tΩ)/sin Ω remplacent les poids (1 − t) et t de l'interpolation linéaire.
- Ne fusionner par SLERP que deux modèles de même architecture, idéalement issus du même modèle de base, et épingler leur révision exacte.
- Refuser les fichiers pickle et le code distant : seuls des poids au format safetensors entrent dans l'environnement de fusion.
- Évaluer le modèle fusionné contre ses deux parents sur des tests métier, des tests de refus et des scénarios de déclencheurs avant tout déploiement.
- Signer le résultat et consigner la configuration YAML, les empreintes et les licences dans un registre interne et une nomenclature AI-BOM.
Que signifie SLERP ? Définition et origine de l'interpolation sphérique
SLERP (Spherical Linear Interpolation) : fonction d'interpolation qui relie deux points d'une sphère par l'arc de grand cercle le plus court, de sorte que l'angle parcouru varie proportionnellement à un paramètre t compris entre 0 et 1, permettant d'obtenir des états intermédiaires de norme constante entre deux rotations, deux vecteurs latents ou deux jeux de poids.
Le sens de l'acronyme, souvent recherché sous la forme « slerp meaning », tient en trois mots : spherical, parce que les points sont considérés sur une sphère ; linear, parce que l'angle évolue linéairement avec le paramètre ; interpolation, parce qu'on calcule des valeurs intermédiaires entre deux extrémités connues. La méthode répond à un problème simple : la moyenne pondérée de deux vecteurs unitaires distincts n'est plus un vecteur unitaire.
L'informaticien Ken Shoemake a présenté la technique à la conférence SIGGRAPH de 1985, dans l'article « Animating Rotation with Quaternion Curves ». Son objectif était d'animer l'orientation d'un objet 3D sans à-coups. Les rotations y sont codées par des quaternions unitaires, c'est-à-dire des points d'une hypersphère à quatre dimensions. Suivre l'arc entre deux quaternions produit une rotation à vitesse angulaire constante autour d'un axe fixe.
La formule géométrique de SLERP ne dépend pourtant ni des quaternions ni de la dimension de l'espace. Elle s'applique aussi bien à deux vecteurs de trois coordonnées qu'à deux matrices de poids de plusieurs millions de valeurs, une fois aplaties en vecteurs. C'est cette généralité qui explique son passage de l'animation 3D à l'apprentissage automatique, puis à la fusion de modèles de langage.
La formule de la slerp interpolation, étape par étape
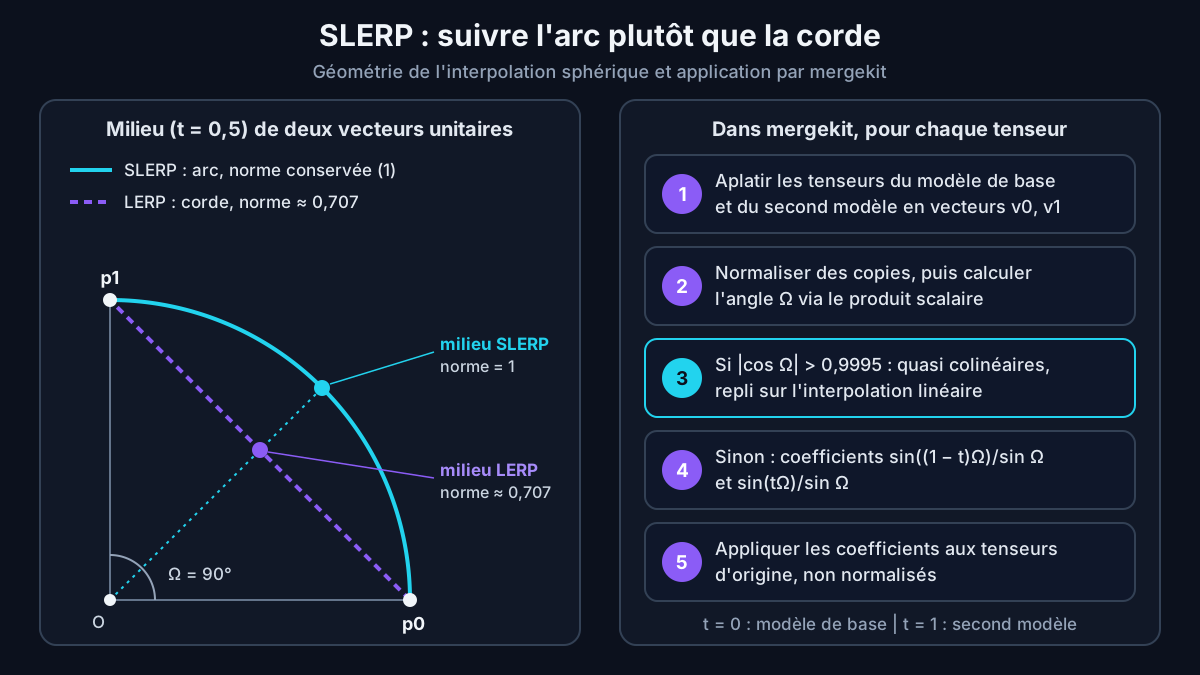
Soit deux vecteurs p₀ et p₁ et un paramètre t compris entre 0 et 1. On note Ω l'angle qui les sépare, obtenu à partir du produit scalaire de leurs versions normalisées : cos Ω = p̂₀ · p̂₁. L'interpolation sphérique s'écrit alors :
slerp(p₀, p₁ ; t) = [sin((1 − t)·Ω) / sin Ω] · p₀ + [sin(t·Ω) / sin Ω] · p₁
Le calcul suit toujours le même enchaînement, que l'on interpole des rotations ou des poids de réseau de neurones :
- normaliser des copies des deux vecteurs pour ne mesurer que leur direction ;
- calculer le produit scalaire, puis l'angle Ω par la fonction arc cosinus ;
- si l'angle est quasi nul, basculer vers l'interpolation linéaire pour éviter une division par un sinus proche de zéro ;
- sinon, calculer les deux coefficients trigonométriques pour la valeur de t choisie ;
- appliquer ces coefficients aux vecteurs et renvoyer la combinaison obtenue.
Plusieurs propriétés découlent directement de la formule. Pour t = 0, on retrouve p₀ ; pour t = 1, on retrouve p₁. L'opération est symétrique : interpoler de p₀ vers p₁ avec t revient à interpoler de p₁ vers p₀ avec 1 − t. Enfin, quand Ω tend vers zéro, les coefficients tendent vers (1 − t) et t, et SLERP se confond avec l'interpolation linéaire classique, appelée LERP.
SLERP contre LERP : pourquoi la conservation de la norme compte
La différence entre SLERP et l'interpolation linéaire (LERP) se voit sur un exemple simple. Prenons deux vecteurs unitaires orthogonaux, donc séparés de 90 degrés. Le milieu calculé par LERP vaut (p₀ + p₁)/2 et sa norme n'est plus que cos 45°, soit environ 0,707. Le milieu calculé par SLERP reste sur le cercle unité, avec une norme égale à 1. La moyenne linéaire raccourcit les vecteurs d'autant plus que l'angle entre eux est grand, alors que SLERP préserve leur longueur.
Deux précautions numériques reviennent dans les implémentations sérieuses de SLERP. La première est le repli sur LERP lorsque les vecteurs sont presque colinéaires, car sin Ω devient trop petit pour une division fiable. La seconde concerne les quaternions : q et −q représentent la même rotation, et l'on inverse l'un des deux quand leur produit scalaire est négatif afin de suivre le chemin le plus court plutôt que le détour de plus de 180 degrés.
Des quaternions aux espaces latents : les usages historiques de SLERP
Dans l'animation 3D, les moteurs de jeu et la robotique, SLERP reste une référence pour interpoler une orientation entre deux images clés. Elle évite les défauts des angles d'Euler, notamment le blocage de cardan, et garantit une vitesse de rotation uniforme. Les bibliothèques mathématiques des moteurs graphiques la proposent généralement sous ce nom, parfois accompagnée d'une variante normalisée plus rapide mais à vitesse moins régulière.
En apprentissage automatique, le chercheur Tom White a proposé en 2016, dans l'article « Sampling Generative Networks », de remplacer l'interpolation linéaire par SLERP pour parcourir l'espace latent des autoencodeurs variationnels (VAE) et des réseaux antagonistes génératifs (GAN). Selon lui, cette substitution évite de s'éloigner de la distribution a priori du modèle et produit des images plus nettes, car la moyenne linéaire de deux points latents tombe anormalement près de l'origine.
Cette justification a d'ailleurs été discutée par des relecteurs de l'époque, qui rappelaient que les points latents ne sont pas tous situés sur une même sphère. Le débat illustre une limite utile pour la suite : SLERP est une heuristique géométrique élégante, pas une garantie que l'objet interpolé conserve le comportement souhaité. Cette prudence vaut encore davantage lorsqu'on l'applique aux milliards de paramètres d'un grand modèle de langage.
SLERP et model merging : fusionner deux LLM sans réentraînement
Le model merging, ou fusion de modèles, consiste à combiner directement les poids de plusieurs modèles déjà entraînés pour obtenir un modèle unique, sans nouvelle phase d'apprentissage. Dans le cas des grands modèles de langage (LLM), on fusionne typiquement un modèle généraliste et une variante spécialisée, par exemple en code ou en médecine. Le modèle résultant garde la taille et le coût d'inférence d'un seul modèle, contrairement à un ensemble de modèles interrogés en parallèle.
La bibliothèque mergekit, décrite par Charles Goddard et ses coauteurs d'Arcee dans un article présenté à la conférence EMNLP 2024, a rendu cette pratique accessible. Selon ses auteurs, elle a servi à produire des milliers de modèles fusionnés, dont beaucoup ont été classés au sommet ou près du sommet des classements publics de LLM ouverts. Son approche hors mémoire permet de fusionner sur processeur seul ou avec une carte graphique de 8 Go.
Les conditions techniques sont strictes. Les deux modèles doivent partager la même architecture et des tenseurs de mêmes dimensions ; les vocabulaires doivent être identiques ou explicitement alignés par la configuration du tokenizer. L'article de MergeKit rappelle que les méthodes par interpolation supposent des architectures et des initialisations identiques, par exemple deux adaptations d'un même modèle de base réalisées selon notre guide pratique du fine-tuning LoRA et QLoRA.
Le choix des parents conditionne tout le reste. Avant même de parler de méthode, il faut savoir d'où viennent les deux modèles, qui les publie, sous quelle licence et avec quelles évaluations. Notre comparatif des LLM open source en 2026 aide à identifier les familles de modèles dont les variantes sont compatibles et documentées, condition préalable à une fusion SLERP reproductible et défendable devant un comité de sécurité.
Comment mergekit applique SLERP, tenseur par tenseur
Dans mergekit, la méthode slerp exige exactement deux modèles, dont l'un est déclaré comme base_model. Le paramètre obligatoire t fixe la position sur l'arc : selon la documentation des méthodes de fusion de mergekit, t = 0 restitue le modèle de base et t = 1 restitue l'autre modèle. La fusion ne traite pas le réseau comme un seul vecteur géant : elle s'applique séparément à chaque tenseur de poids.
Le code source de la méthode SLERP de mergekit révèle un détail important. Les copies normalisées des deux tenseurs servent uniquement à mesurer l'angle ; les coefficients sont ensuite appliqués aux tenseurs d'origine, non normalisés. Si la valeur absolue du produit scalaire normalisé dépasse 0,9995, les tenseurs sont jugés quasi colinéaires et l'outil effectue une simple interpolation linéaire.
Ce seuil a une conséquence concrète : quand deux variantes très proches d'un même modèle sont fusionnées, une partie des tenseurs peut être combinée par moyenne linéaire plutôt que par SLERP, sans avertissement particulier. Ce n'est pas un défaut, car les deux méthodes convergent pour des angles faibles, mais cela nuance tout gain attribué à la géométrie sphérique. D'après la documentation, les calculs sont effectués en float32 pour des poids fournis en float16 ou bfloat16.
Configurer une fusion SLERP dans mergekit : exemple commenté
Dans mergekit, le paramètre t d'une fusion SLERP peut varier d'une couche à l'autre. L'outil accepte des listes de valeurs interpolées selon la profondeur et des filtres sur le nom des tenseurs, par exemple pour distinguer les blocs d'attention (self_attn) des perceptrons multicouches (mlp). Pour plus de deux modèles, la bibliothèque propose les variantes Multi-SLERP et moyenne de Karcher ; NuSLERP permet en outre d'interpoler des vecteurs de tâche relatifs à un ancêtre commun.
slices:
  - sources:
      - model: ./parents/base
        layer_range: [0, 32]
      - model: ./parents/specialise
        layer_range: [0, 32]
merge_method: slerp
base_model: ./parents/base
parameters:
  t:
    - filter: self_attn
      value: [0, 0.5, 0.3, 0.7, 1]
    - filter: mlp
      value: [1, 0.5, 0.7, 0.3, 0]
    - value: 0.5
dtype: bfloat16
Dans ce fichier slerp.yml, inspiré des exemples fournis avec mergekit, les deux parents sont des copies locales déjà vérifiées. Les couches d'attention oscillent entre le modèle de base et le modèle spécialisé selon la profondeur, tandis que les blocs MLP suivent le profil inverse. Tous les autres tenseurs, comme les embeddings et les normalisations, reçoivent t = 0,5. Ces valeurs ne sont pas une recommandation : elles se choisissent par évaluation.
Conseil d'expert : versionnez le fichier YAML de fusion avec les empreintes SHA-256 des parents et du résultat. Une fusion SLERP est déterministe : mêmes révisions, même version de mergekit et même matériel doivent redonner des tenseurs identiques ou quasi identiques. Cette reproductibilité devient un contrôle d'intégrité : si un tiers vous livre un modèle « fusionné à partir de A et B », rejouez sa configuration et comparez les tenseurs un à un, avec une tolérance numérique.
Retour terrain : Cas typique rencontré en mission — une équipe reprend tel quel un profil de t issu d'un exemple public. Ses parents dérivant du même modèle de base, une partie notable des tenseurs, quasi colinéaires, bascule en interpolation linéaire : l'apport sphérique attendu reste marginal. L'effet visible se lit ailleurs, sur les tests de refus, souvent dégradés par le parent spécialisé. Je recommande de mesurer la similarité cosinus des tenseurs avant fusion et de rejouer la batterie de refus pour chaque profil de t candidat.
SLERP, linéaire, TIES ou DARE : quelle méthode de fusion choisir ?
SLERP n'est qu'une méthode parmi la quinzaine proposée par mergekit. Elle se distingue par sa limite à deux modèles et par son comportement géométrique, mais d'autres approches répondent mieux à certains besoins, notamment la combinaison de plusieurs spécialisations. Le tableau ci-dessous résume les méthodes les plus courantes, leurs prérequis et le principal point de vigilance qu'elles posent du point de vue de la sécurité.
| Méthode | Modèles fusionnés | Modèle de base | Principe | Point de vigilance sécurité |
|---|---|---|---|---|
| Linéaire (linear) | 2 ou plus | Sans effet | Moyenne pondérée des poids, à la manière des « model soups » | Chaque parent contribue selon son poids : un parent compromis reste présent |
| SLERP (slerp) | Exactement 2 | Obligatoire | Interpolation sur l'arc entre deux tenseurs, réglée par t | Avec t proche de 0,5, les deux parents pèsent autant et exigent la même confiance |
| NuSLERP (nuslerp) | Exactement 2 | Facultatif | SLERP pondéré, éventuellement appliqué aux vecteurs de tâche | Le modèle ancêtre devient une troisième dépendance à vérifier |
| Multi-SLERP (multislerp) | 2 ou plus | Facultatif | Interpolation barycentrique sur l'hypersphère | Chaque parent supplémentaire élargit la surface d'attaque de la chaîne d'approvisionnement |
| Task Arithmetic | 2 ou plus | Obligatoire | Somme pondérée des différences entre chaque modèle et la base | Le facteur d'échelle agit aussi sur l'intensité d'un vecteur de tâche malveillant |
| TIES et DARE | 2 ou plus | Obligatoire | Vecteurs de tâche élagués, avec consensus de signe (TIES, Trim, Elect Sign and Merge) ou élagage aléatoire et remise à l'échelle (DARE, Drop And Rescale) | TIES figure parmi les méthodes évaluées par plusieurs travaux sur les portes dérobées et la propriété intellectuelle |
| Passthrough | 1 par tranche | Sans effet | Copie de couches entières pour assembler un modèle (« frankenmerge ») | Architecture modifiée : les évaluations des parents ne s'appliquent plus |
Pour un premier projet, la documentation de mergekit conseille de commencer par la fusion linéaire, NuSLERP ou Task Arithmetic, et rappelle qu'aucune méthode n'est meilleure dans l'absolu. SLERP reste pertinente pour obtenir un compromis réglable entre exactement deux modèles proches, par exemple un modèle généraliste et sa variante affinée sur un domaine. Quelle que soit la méthode, la question de sécurité ne change pas : chaque parent est une dépendance logicielle à qualifier.
Pourquoi la fusion de modèles est un sujet de cybersécurité
Un modèle fusionné n'est pas seulement le produit d'un calcul : c'est un nouvel artefact logiciel dont la confiance dépend de ses composants. L'OWASP le reconnaît explicitement dans le risque LLM03:2025 Supply Chain de son Top 10 pour les applications de grands modèles de langage (LLM) : il cite les services collaboratifs de fusion et de conversion de modèles parmi les vecteurs exploitables et souligne que la fusion peut servir à contourner les revues.
Le même référentiel rappelle qu'il n'existe pas aujourd'hui de garantie forte de provenance pour les modèles publiés : la fiche de modèle (model card) documente, mais ne prouve rien. Un compte d'éditeur compromis, un dépôt au nom trompeur ou une copie republiée après le retrait de l'original suffisent à introduire un parent piégé. Le référentiel MITRE ATLAS range ces scénarios dans la technique AML.T0010, compromission de la chaîne d'approvisionnement de l'IA, qui comporte une sous-technique dédiée aux modèles.
Le risque le plus immédiat ne vient pas des poids eux-mêmes mais des fichiers qui les transportent. Les formats fondés sur la sérialisation Python, comme pickle, peuvent exécuter du code au chargement. Le guide de l'ANSSI sur la sécurité des systèmes d'IA générative recommande d'utiliser des formats à l'état de l'art comme safetensors et de proscrire pickle (recommandation R6).
4,47 millions de versions uniques de modèles, réparties dans 1,41 million de dépôts du Hugging Face Hub, avaient été analysées par Protect AI au 1er avril 2025. L'analyse a relevé 352 000 problèmes jugés dangereux ou suspects sur 51 700 modèles. Source : Hugging Face et Protect AI, « 4M Models Scanned », billet du 14 avril 2025.
Ces chiffres ne concernent pas spécifiquement les modèles fusionnés, mais ils décrivent l'écosystème dans lequel on choisit les parents d'une fusion SLERP. Ils rappellent qu'un dépôt public populaire n'est pas un dépôt sûr par défaut. La fusion ajoute une difficulté : le modèle obtenu ne porte plus la signature ni l'historique de ses parents, et ses évaluations publiques ne disent rien des comportements cachés qui n'apparaissent qu'en présence d'un déclencheur.
Portes dérobées et désalignement : ce que montre la recherche sur la fusion
La recherche académique a montré dès 2024 que la fusion de modèles ouvre une surface d'attaque spécifique. Les travaux BadMerging, présentés à la conférence ACM CCS 2024, décrivent la première attaque par porte dérobée conçue pour la fusion : un adversaire qui fournit un seul modèle piégé peut compromettre le modèle fusionné tout entier. L'étude portait sur des encodeurs visuels de type CLIP et sur des méthodes à base de vecteurs de tâche.
En 2025, l'article Merge Hijacking, accepté à la conférence ACL 2025, a transposé le problème aux grands modèles de langage (LLM). Ses auteurs publient un modèle malveillant d'apparence utile ; lorsqu'une victime le fusionne avec d'autres modèles, le résultat hérite de la porte dérobée tout en conservant ses performances sur les tâches visées. L'attaque reste efficace face à deux défenses appliquées à l'inférence et à une défense appliquée à l'entraînement.
Le risque ne se limite pas aux portes dérobées délibérées. Une étude de Hammoud et de ses coauteurs, publiée dans les actes Findings d'EMNLP 2024 sous le titre « One Bad Model Spoils the Bunch », montre que les techniques de fusion courantes transfèrent l'expertise des modèles mais propagent aussi leur désalignement : fusionner un modèle dépourvu de garde-fous avec des modèles alignés peut produire un modèle mal aligné.
Deux résultats complètent le tableau. Les travaux de Cong et de ses coauteurs, présentés à l'atelier CCS-LAMPS 2024, indiquent que les tatouages numériques testés ne survivent pas à la fusion, alors que les empreintes par instruction résistent. À l'inverse, Arora et ses coauteurs ont proposé en 2024 d'utiliser la fusion pour atténuer des portes dérobées. La fusion n'est donc ni une désinfection fiable ni un vecteur de compromission systématique : son effet dépend des parents et doit être mesuré.
Une nuance s'impose pour SLERP : la plupart de ces études évaluent des méthodes à base de vecteurs de tâche, comme Task Arithmetic ou TIES, et ne démontrent pas que chaque fusion SLERP est vulnérable. Le principe sous-jacent demeure : une interpolation à t = 0,5 conserve une contribution importante de chaque parent, et rien dans la formule ne filtre un comportement indésirable. La seule posture crédible consiste à traiter chaque parent comme non fiable jusqu'à preuve du contraire.
Avertissement : les attaques citées sont présentées pour comprendre le risque et concevoir des défenses. Toute expérimentation portant sur des portes dérobées ou des modèles piégés doit se dérouler dans un environnement isolé, sur des modèles dont vous maîtrisez les droits, dans un cadre contractuel ou de recherche autorisé, et sans jamais publier d'artefact malveillant sur une plateforme publique.
Licences et propriété intellectuelle : les angles morts d'un modèle fusionné
Un modèle fusionné doit être traité comme un dérivé de ses deux parents. Les conditions de chaque licence s'appliquent donc au résultat, et elles ne sont pas toujours compatibles : certaines licences communautaires imposent des mentions, des restrictions d'usage ou des règles de dénomination aux modèles dérivés, que n'exigent pas les licences permissives comme Apache 2.0. L'OWASP classe ces incompatibilités parmi les risques de la chaîne d'approvisionnement et recommande de les inventorier dans une nomenclature.
La propriété intellectuelle pose aussi une question de traçabilité. Si les tatouages numériques des modèles d'origine disparaissent lors de la fusion, comme l'ont observé Cong et ses coauteurs pour les techniques testées, l'éditeur d'un modèle peut perdre un moyen de prouver sa réutilisation. Pour l'organisation qui fusionne, la conséquence est simple : conserver la configuration, les révisions et les licences des parents afin de pouvoir démontrer l'origine du modèle en cas de litige ou d'audit.
AI Act : une fusion SLERP fait-elle de vous un fournisseur de modèle ?
Sur le plan réglementaire, les obligations du règlement européen sur l'intelligence artificielle (AI Act) applicables aux fournisseurs de modèles d'IA à usage général sont entrées en application le 2 août 2025. Selon les lignes directrices de la Commission européenne, un acteur qui modifie un tel modèle n'en devient fournisseur que si la modification change significativement sa généralité, ses capacités ou son risque systémique, avec pour critère indicatif un calcul d'entraînement supérieur au tiers de celui du modèle d'origine.
Une fusion SLERP ne mobilise quasiment aucun calcul d'entraînement : au regard de ce seul critère, elle ne devrait généralement pas faire de l'intégrateur le fournisseur du modèle. Elle ne dispense pas pour autant des obligations attachées au système d'IA qui l'embarque, ni de l'analyse au cas par cas que prévoit la Commission. Cette lecture doit être validée par un juriste, d'autant que la Commission indique que son approche pourra évoluer.
Sécuriser une chaîne de fusion SLERP de bout en bout
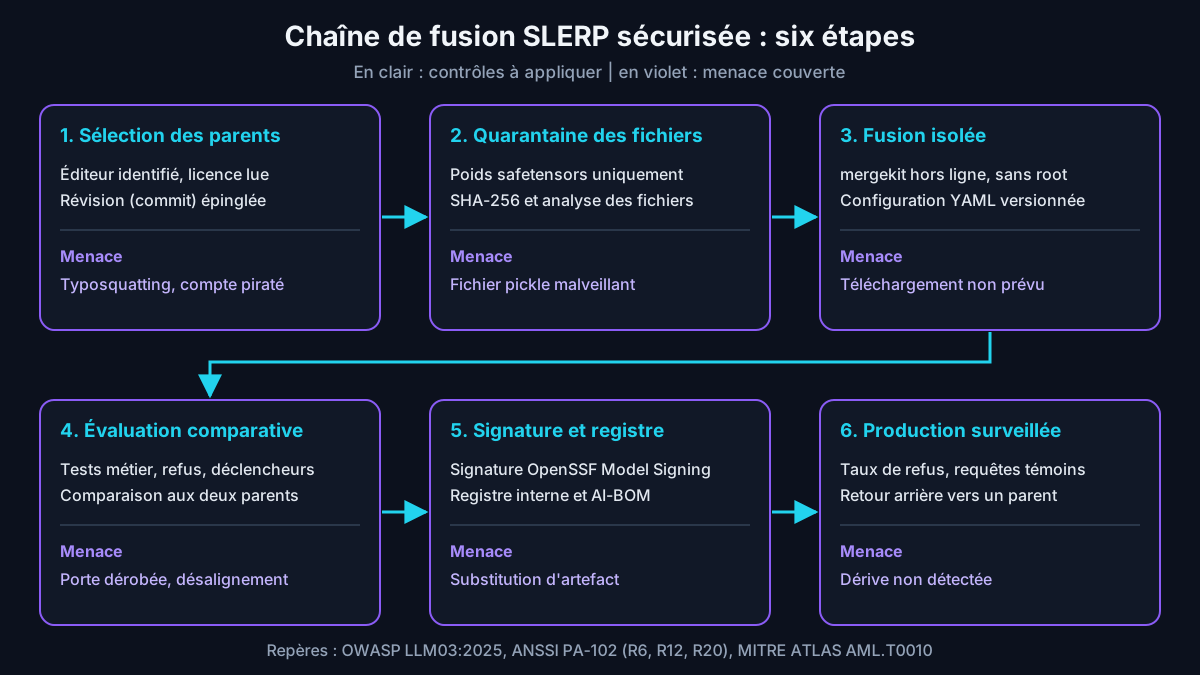
Sécuriser une fusion SLERP revient à appliquer à deux modèles les principes de sécurité de la chaîne d'approvisionnement logicielle, puis à vérifier le comportement du résultat. Le schéma ci-dessous découpe le processus en six étapes, chacune associée à une menace et à des contrôles. Les recommandations de l'ANSSI sur le cloisonnement des environnements d'entraînement, de déploiement et de production (R12) et sur l'intégrité des fichiers du modèle (R20) s'y appliquent directement.
Avant la fusion : provenance, révision et format
- Choisir des parents publiés par des éditeurs identifiés, vérifier l'ancienneté du compte et l'historique du dépôt, et refuser les copies republiées sous un nom proche.
- Épingler chaque parent à un identifiant de révision (commit) précis, jamais à une branche mobile, et consigner les empreintes SHA-256 des fichiers.
- N'accepter que des poids au format safetensors et rejeter tout fichier .bin, .pt, .pkl ou script Python exigeant l'exécution de code distant.
- Analyser les fichiers avec un outil d'inspection de modèles et vérifier les licences des deux parents avant toute fusion.
Pendant la fusion : isolement et traçabilité
La fusion s'exécute dans un environnement dédié, sans accès Internet une fois les parents copiés, avec un compte non privilégié et un stockage séparé de la production. La configuration YAML, la version exacte de mergekit et les journaux d'exécution sont archivés. Ce cloisonnement limite l'impact d'un fichier piégé qui aurait échappé aux contrôles et garantit qu'aucun téléchargement imprévu ne vient modifier les entrées.
hf download editeur/modele-base --revision REVISION_SHA_BASE \
  --include "*.safetensors" "*.json" --local-dir ./parents/base
hf download editeur/modele-specialise --revision REVISION_SHA_SPEC \
  --include "*.safetensors" "*.json" --local-dir ./parents/specialise

find ./parents -type f \( -name "*.bin" -o -name "*.pt" -o -name "*.pkl" -o -name "*.py" \) | grep -q . \
  && echo "Format à risque détecté : fusion refusée" && exit 1

sha256sum ./parents/*/*.safetensors > parents.sha256
HF_HUB_OFFLINE=1 mergekit-yaml slerp.yml ./modele-fusionne
sha256sum ./modele-fusionne/*.safetensors > fusion.sha256
Ce script télécharge les deux parents à une révision figée en excluant les formats exécutables, bloque la fusion si un fichier à risque subsiste, calcule les empreintes des entrées, lance mergekit hors ligne grâce à la variable HF_HUB_OFFLINE, puis calcule les empreintes du résultat. Les identifiants de révision et les noms de dépôts sont des exemples à remplacer.
Environnement de test décrit : maquette isolée sous Debian 13 (machine virtuelle sans accès Internet après la copie des parents, 64 Go de mémoire vive, exécution sur processeur), Python 3.12, mergekit installé depuis le dépôt d'Arcee à un commit épinglé, deux modèles de 7 milliards de paramètres dérivés d'un même modèle de base au format safetensors, ModelScan pour l'inspection des fichiers, lm-evaluation-harness pour les tests métier et garak pour les sondes de sécurité. Cette maquette sert à valider la procédure ; aucun résultat chiffré n'est rapporté ici.
Après la fusion : évaluation comparative, signature et AI-BOM
Une fois la fusion SLERP terminée, le modèle obtenu est évalué contre ses deux parents sur trois familles de tests : des tests métier représentatifs de l'usage visé, des tests de refus et de sécurité, et des sondes de déclencheurs. Un comportement absent des deux parents doit bloquer le déploiement. Le modèle validé est ensuite signé, par exemple selon la spécification OpenSSF Model Signing, publiée en version 1.0 en avril 2025, puis enregistré dans un registre interne.
Ce registre s'accompagne d'une nomenclature de composants d'IA, ou AI-BOM, que l'OWASP suggère de produire au format CycloneDX. Elle recense les deux parents, leurs révisions, leurs licences, la méthode SLERP, les valeurs de t, la version de mergekit et les empreintes. Si le modèle doit ensuite tourner sur un serveur interne, notre comparatif Ollama, LM Studio ou vLLM pour un LLM local détaille les options de service et leurs contrôles d'accès.
Auditer et surveiller un modèle fusionné en production
Lorsqu'un modèle présenté comme une fusion SLERP arrive dans votre périmètre, livré par un fournisseur ou par une équipe interne, la première vérification porte sur sa filiation. Une fusion SLERP produit, tenseur par tenseur, une combinaison de deux parents. Mesurer la similarité cosinus entre les tenseurs du modèle livré et ceux des parents déclarés permet de repérer un modèle dont l'origine annoncée ne correspond pas aux poids réellement fournis.
La deuxième vérification consiste à rejouer la configuration fournie avec les révisions déclarées, puis à comparer le résultat au modèle livré. Un écart au-delà de la tolérance numérique signale une étape non documentée : affinage supplémentaire, ajout d'un adaptateur LoRA (Low-Rank Adaptation) ou substitution de fichiers. Cette approche transpose aux poids d'un réseau de neurones un principe classique de la sécurité logicielle, la construction reproductible.
En production, la surveillance porte sur le comportement plutôt que sur les fichiers. Le taux de refus sur des requêtes sensibles, la stabilité des réponses à un jeu de requêtes témoins et l'apparition de formulations inhabituelles en présence de certains mots doivent être suivis dans le temps. Si un réalignement s'impose après la fusion, les techniques présentées dans notre article sur DPO, ORPO et LoRA en 2026 permettent de le conduire sans repartir de zéro.
Enfin, il faut se demander si la fusion était la bonne réponse au besoin. Pour injecter des connaissances documentaires à jour, la génération augmentée par récupération (RAG) reste souvent plus simple à gouverner qu'un nouveau modèle, comme l'explique notre comparatif RAG, fine-tuning ou prompt engineering. Retour terrain : Cas typique rencontré en mission — un prestataire livre un modèle présenté comme une fusion SLERP de deux modèles publics, configuration et révisions à l'appui. La similarité cosinus confirme la filiation, mais la fusion rejouée diverge nettement sur les couches d'attention, au-delà de la tolérance : une étape d'affinage n'a pas été déclarée. La mise en production est suspendue jusqu'à la fourniture de la chaîne complète ; à défaut, la fusion est rejouée en interne à partir des parents vérifiés.
À lire aussi : l'index vectoriel HNSW ; les menaces IA de MITRE ATLAS.
Questions fréquentes
Que signifie SLERP en intelligence artificielle ?
SLERP signifie Spherical Linear Interpolation, soit interpolation linéaire sphérique. En intelligence artificielle, le terme a d'abord désigné une façon de parcourir l'espace latent des modèles génératifs, puis une méthode de fusion de grands modèles de langage. Dans ce second usage, chaque tenseur de poids de deux modèles est traité comme un vecteur, et l'on calcule un point intermédiaire situé sur l'arc qui les relie, selon un paramètre t compris entre 0 et 1. Le modèle obtenu combine les comportements des deux parents sans réentraînement. Le terme vient de l'animation 3D, où Ken Shoemake l'a popularisé en 1985 pour interpoler des rotations représentées par des quaternions.
Quelle est la différence entre SLERP et une interpolation linéaire ?
L'interpolation linéaire, ou LERP, trace une ligne droite entre deux vecteurs et calcule (1 − t)·p₀ + t·p₁. SLERP suit l'arc de cercle entre leurs directions et remplace ces poids par sin((1 − t)Ω)/sin Ω et sin(tΩ)/sin Ω, où Ω est l'angle entre les vecteurs. Pour deux vecteurs unitaires séparés de 90 degrés, le milieu linéaire a une norme d'environ 0,707, alors que le milieu sphérique conserve une norme de 1. Lorsque l'angle est très faible, les deux méthodes donnent presque le même résultat, ce qui explique que mergekit bascule vers l'interpolation linéaire au-delà d'un produit scalaire normalisé de 0,9995.
Pourquoi la méthode SLERP de mergekit ne fusionne-t-elle que deux modèles ?
La formule de SLERP est définie entre deux points : elle décrit un arc unique entre deux extrémités et un paramètre t qui indique la position sur cet arc. Avec trois modèles ou plus, il n'existe plus un arc unique mais une infinité de chemins possibles sur l'hypersphère. Mergekit impose donc exactement deux modèles pour la méthode slerp, dont un modèle de base. Pour aller au-delà, la bibliothèque propose Multi-SLERP, qui réalise une interpolation barycentrique sur l'hypersphère, et la moyenne de Karcher, qui calcule un barycentre géométrique. Enchaîner plusieurs fusions SLERP successives reste possible, mais chaque étape ajoute un parent à vérifier et complique la traçabilité.
Un modèle fusionné par SLERP peut-il contenir une porte dérobée ?
Oui, c'est possible. La formule SLERP ne filtre aucun comportement : elle mélange les poids des deux parents, et une porte dérobée présente dans l'un d'eux peut survivre dans le résultat. Les travaux BadMerging, présentés à CCS 2024, et Merge Hijacking, accepté à ACL 2025, ont montré que des modèles piégés peuvent être conçus pour résister à la fusion, même si ces études portent surtout sur des méthodes à base de vecteurs de tâche. La parade consiste à vérifier la provenance des parents, à n'accepter que des fichiers safetensors, à fusionner dans un environnement isolé, puis à comparer le comportement du modèle fusionné à celui de ses parents avant tout déploiement.
Comment choisir la valeur du paramètre t dans une fusion SLERP ?
Il n'existe pas de valeur universelle. Avec t = 0, on conserve le modèle de base ; avec t = 1, on obtient l'autre modèle ; t = 0,5 donne un compromis à égale distance angulaire des deux parents. Mergekit permet aussi de faire varier t selon la profondeur des couches et selon le type de tenseur, par exemple attention ou MLP. La bonne méthode consiste à produire quelques candidats, puis à les évaluer sur un jeu de tests métier, des tests de refus et des tests de sécurité. Il faut retenir la valeur qui atteint l'objectif fonctionnel sans dégrader l'alignement, puis documenter ce choix dans le registre de modèles.
Conclusion
SLERP est une idée mathématique ancienne et robuste : suivre l'arc plutôt que la corde pour interpoler sans raccourcir les vecteurs. Appliquée aux poids des LLM par mergekit, elle crée un modèle intermédiaire sur du matériel modeste. Le risque se déplace alors vers la chaîne d'approvisionnement : provenance, formats de fichiers, portes dérobées héritées, alignement et licences. Un modèle fusionné doit être traité comme un composant tiers non fiable tant qu'il n'a pas été vérifié, testé et signé.
Pour aller plus loin, notre article pilier sur le fine-tuning de LLM avec LoRA et QLoRA présente les techniques d'adaptation qui produisent les modèles que l'on fusionne ensuite, et notre exemple pratique d'entraînement QLoRA pas à pas montre comment documenter chaque étape d'un projet d'affinage.
Faire auditer votre chaîne de fusion et de fine-tuning
Ayi NEDJIMI accompagne les équipes data et sécurité dans l'audit de leurs pipelines de modèles : provenance des parents, isolement des environnements, tests de refus et de portes dérobées, signature et registre de modèles. Échangeons sur votre contexte et vos contraintes.
Demander un audit de sécurité IAÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Testez vos connaissances
Mini-quiz de certification lié à cet article — propulsé par CertifExpress
Articles connexes
HNSW : comprendre, régler et sécuriser l'index vectoriel du RAG
Comment fonctionne l'algorithme HNSW, comment régler M et ef_search, combien de mémoire prévoir et comment sécuriser un index vectoriel partagé dans un RAG en 2026.
Benchmark LLM novembre 2026 : classement complet des IA
Édition #10 : Gemini 4 Carbon mène l'index v5.0 et l'Arena. Classement complet, prix, débit, modèles ouverts, Mistral et méthodologie, avec chaque source datée.
Benchmark LLM Août 2026 : Kimi K3 prend un classement Arena, la guerre des prix s'ouvre
Édition #8 : Kimi K3 devient le premier modèle à poids ouverts à dominer un classement LMArena. Grok 4.6 et DeepSeek V4 Pro sortent le même jour et déclenchent une guerre des prix.
Sécurisez vos systèmes d'IA & LLM
Red teaming LLM, audit RAG, détection shadow AI, gouvernance des usages IA en entreprise. Expertise technique et réglementaire (EU AI Act).
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Laisser un commentaire