






Méthode pas à pas pour modéliser les menaces d'un agent IA : cartographie, injection indirecte, permissions, mémoire, MCP et matrice de contrôles vérifiables.
La sécurité des agents IA ne se résume plus à filtrer les réponses d'un chatbot : un agent lit des documents, appelle des outils, écrit dans des systèmes métier et prend des décisions en chaîne, parfois sans validation humaine. En 2026, les entreprises qui connectent un grand modèle de langage à leur messagerie, à leur CRM ou à leur annuaire exposent une nouvelle surface d'attaque, où une simple page web ou un courriel piégé peut suffire à détourner l'agent. La réponse la plus efficace consiste à modéliser les menaces avant le déploiement : cartographier les composants de l'agent, identifier les frontières de confiance, recenser les scénarios d'abus propres à l'IA agentique, puis associer à chacun un contrôle vérifiable. Ce guide détaille cette méthode pas à pas, en s'appuyant sur les travaux de l'OWASP, du NIST et de MITRE ATLAS, pour aider architectes, RSSI et équipes de développement à concevoir un agent sûr dès l'origine plutôt qu'à corriger après incident. Il complète notre analyse de la surface d'attaque de l'IA agentique.
Résumé exécutif : un agent IA hérite des privilèges des outils qu'on lui confie et des données qu'il lit. Le risque principal n'est pas le modèle lui-même, mais la combinaison d'entrées non fiables, d'outils puissants et d'une autonomie excessive. Une modélisation des menaces structurée, réalisée avant la mise en production, permet de réduire le rayon d'impact, de rendre chaque action traçable et de placer un humain aux points de décision critiques.
Points clés de cet article :
- Traiter toute donnée lue par l'agent (web, courriel, document, résultat d'outil) comme une entrée non fiable susceptible de contenir des instructions.
- Limiter le rayon d'impact : identité propre à l'agent, permissions minimales par outil, jetons à durée de vie courte.
- Exiger une validation humaine pour toute action irréversible ou sortante (paiement, envoi externe, suppression, modification de droits).
- Journaliser chaque décision et chaque appel d'outil avec un identifiant de corrélation pour garantir la non-répudiation.
- Tester l'agent en continu avec des scénarios d'injection indirecte et de détournement d'objectif avant chaque nouvelle version.
Qu'est-ce qu'un agent IA du point de vue de la sécurité ?
Agent IA : système logiciel qui utilise un modèle de langage pour planifier et exécuter une suite d'actions afin d'atteindre un objectif, en appelant des outils externes (API, bases de données, navigateur, terminal) et en conservant éventuellement une mémoire entre les tâches.
Pour un analyste sécurité, un agent IA se décompose en cinq éléments : une interface d'entrée qui reçoit la demande, un modèle qui raisonne et planifie, un orchestrateur qui exécute les étapes, un ensemble d'outils dotés de permissions réelles et une mémoire qui conserve contexte et historique. Chaque élément introduit des risques distincts, et c'est leur combinaison qui crée des chemins d'attaque inédits.
La différence majeure avec une application classique tient au fait que le flux de contrôle n'est pas écrit à l'avance par un développeur. Il est décidé à l'exécution par le modèle, à partir de textes qui peuvent provenir de sources externes. Un agent qui résume des courriels et peut aussi en envoyer transforme donc chaque message reçu en vecteur potentiel de commande.
Cette propriété impose de raisonner en termes de frontières de confiance plutôt qu'en termes de fonctionnalités. La question n'est plus seulement « que fait l'agent ? », mais « qui peut influencer ce que l'agent décide de faire, et avec quels privilèges ? ». Les architectures détaillées dans notre guide sur l'architecture des agents autonomes constituent un bon point de départ pour identifier ces éléments.
Pourquoi la sécurité des agents IA exige une modélisation des menaces dédiée
Les méthodes de modélisation existantes, comme STRIDE ou les arbres d'attaque, restent pertinentes, mais elles ne couvrent pas naturellement les comportements propres aux modèles de langage. Un modèle peut être persuadé de changer d'objectif, inventer une étape, mal interpréter une instruction ambiguë ou exécuter un ordre dissimulé dans un document. Ces défaillances n'ont pas d'équivalent direct dans une application déterministe.
Le projet OWASP GenAI Security Project a publié des travaux spécifiques aux applications agentiques, qui recensent des menaces comme l'empoisonnement de la mémoire, le détournement d'outils, la compromission de privilèges, l'usurpation d'identité entre agents ou la surcharge des validations humaines. Ces catégories complètent les risques déjà décrits pour les applications fondées sur des modèles de langage.
Modéliser les menaces avant le déploiement présente trois bénéfices concrets. D'abord, les décisions d'architecture les plus structurantes, comme le choix des outils exposés ou le niveau d'autonomie, se prennent à ce moment-là et coûtent cher à modifier ensuite. Ensuite, la modélisation produit une liste de contrôles vérifiables qui sert de base aux tests et à l'audit. Enfin, elle documente les risques résiduels acceptés, ce qu'exigent les référentiels de gouvernance et la réglementation européenne.
Une modélisation utile reste courte et vivante : un schéma, une matrice de menaces et une liste de contrôles, révisés à chaque ajout d'outil ou de source de données. Elle s'intègre au cycle de développement plutôt que de constituer un livrable figé.
Cartographier l'agent : composants, flux et frontières de confiance
La première étape consiste à dessiner l'agent tel qu'il fonctionnera réellement en production, et non tel qu'il apparaît dans une démonstration. Ce schéma doit faire apparaître toutes les entrées, tous les outils et tous les stockages, ainsi que l'identité sous laquelle chaque action est exécutée.
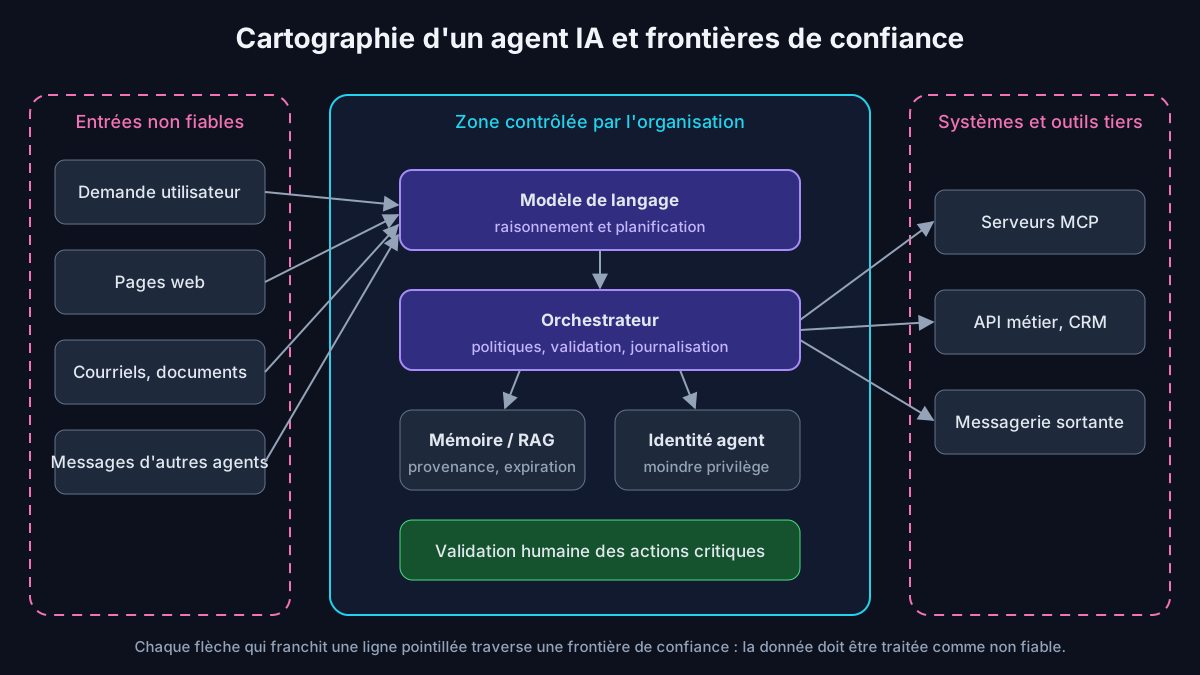
Pour chaque composant, notez les informations suivantes dans un tableau de travail :
- Sources d'entrée : demande de l'utilisateur, pages web, courriels, fichiers, résultats d'API, messages d'autres agents.
- Outils : nom, action réalisée, système cible, caractère réversible ou non, données accessibles.
- Identité d'exécution : compte de service dédié, délégation au nom de l'utilisateur ou compte partagé.
- Stockages : mémoire conversationnelle, base vectorielle, journaux, caches.
- Sorties : réponse à l'utilisateur, écriture dans un système, envoi vers l'extérieur.
Tracez ensuite les frontières de confiance : chaque fois qu'une donnée passe d'une zone contrôlée par l'organisation à une zone influençable par un tiers, une frontière existe. Le contenu d'une page web consultée par l'agent, un document partagé par un partenaire ou la réponse d'un serveur d'outils externe franchissent tous une frontière et doivent être considérés comme non fiables.
Cette cartographie révèle souvent un premier problème majeur : un agent qui lit des contenus externes et dispose simultanément d'un outil d'envoi ou d'écriture. C'est la combinaison classique qui permet l'exfiltration de données par injection indirecte.
Retour d'expérience : lors des revues d'architecture d'agents IA que je conduis, le même schéma revient très souvent : un assistant interne connecté à la messagerie ou à l'outil de tickets, capable à la fois de lire des contenus reçus de l'extérieur et d'envoyer des messages ou de modifier des enregistrements, le tout sous un compte de service aux droits larges hérités du prototype. Dans ce type de configuration, un simple courriel contenant des instructions suffit généralement, en test autorisé, à faire déclencher à l'agent une action que personne n'a demandée. Les corrections les plus efficaces sont rarement liées au modèle : séparer la lecture de l'action, restreindre les destinataires autorisés et remplacer le compte partagé par une identité dédiée.
Les familles de menaces propres aux agents IA
Une fois l'agent cartographié, il faut confronter chaque composant à une liste de menaces. Le tableau suivant regroupe les familles les plus fréquentes, avec le composant concerné et le contrôle prioritaire associé. Il sert de point de départ à la matrice de l'organisation.
| Famille de menace | Composant visé | Exemple de scénario | Contrôle prioritaire |
|---|---|---|---|
| Injection de prompt indirecte | Entrées externes | Instruction cachée dans une page web consultée | Séparation des données et des instructions, outils restreints |
| Détournement d'objectif | Modèle et planification | L'agent abandonne sa tâche pour une autre | Objectifs bornés, validation des plans |
| Abus d'outils | Outils | Appel d'une API avec des paramètres dangereux | Liste blanche de paramètres, validation côté serveur |
| Compromission de privilèges | Identité d'exécution | Agent opérant avec un compte administrateur | Identité dédiée, moindre privilège, jetons courts |
| Empoisonnement de la mémoire | Mémoire et RAG | Fausse information injectée et réutilisée | Provenance des données, expiration, revue |
| Fuite de données | Sorties | Données sensibles envoyées vers un domaine externe | Filtrage des sorties, liste blanche de destinations |
| Chaîne d'approvisionnement des outils | Serveurs MCP, plugins | Outil tiers modifié pour exfiltrer | Inventaire, épinglage des versions, revue |
| Défaut de traçabilité | Orchestrateur | Impossible de reconstituer une décision | Journalisation corrélée et immuable |
Chaque ligne de cette matrice doit être déclinée pour l'agent étudié : quels outils précis sont concernés, quel serait l'impact métier, quelle est la probabilité compte tenu des entrées exposées. Les cas les plus critiques combinent généralement une entrée non fiable, un outil puissant et l'absence de validation humaine. MITRE recense également des techniques d'attaque visant les systèmes d'IA dans la base MITRE ATLAS, utile pour enrichir les scénarios.
Injection de prompt indirecte et détournement d'objectif
L'injection de prompt indirecte est la menace la plus caractéristique des agents. Contrairement à l'injection directe, où l'utilisateur tente lui-même de contourner les consignes, l'injection indirecte provient d'un contenu que l'agent lit dans le cadre de sa tâche : une page web, un courriel, un commentaire de code ou une pièce jointe. Le texte malveillant se présente comme une instruction et le modèle peut la suivre.
L'injection de prompt figure en première position (LLM01) du Top 10 OWASP des risques pour les applications LLM, devant la divulgation d'informations sensibles.
Source : OWASP Top 10 for LLM Applications, édition 2025.
Aucune technique de filtrage ne supprime totalement ce risque, car le modèle traite instructions et données dans le même flux de texte. La défense repose donc sur la limitation des conséquences plutôt que sur la détection parfaite. Les mesures les plus efficaces sont les suivantes :
- Marquer explicitement les contenus externes comme des données, dans des sections délimitées, et rappeler au modèle qu'ils ne contiennent pas d'instructions.
- Retirer à l'agent les outils dont il n'a pas besoin pour la tâche en cours, en particulier les outils d'envoi et d'écriture.
- Faire valider par un composant déterministe, hors du modèle, tout plan d'action qui sort du périmètre prévu.
- Exiger une confirmation humaine pour les actions sortantes ou irréversibles.
Le détournement d'objectif est la conséquence directe d'une injection réussie : l'agent poursuit un autre but que celui fixé par l'utilisateur. Borner les objectifs, limiter le nombre d'étapes et comparer le plan exécuté au plan attendu permettent de détecter ces dérives. Les variantes d'attaque sont détaillées dans notre article consacré au jailbreak d'agents et à l'injection via les outils.
Outils, permissions et identités : limiter le rayon d'impact
Le principe de moindre privilège s'applique aux agents avec encore plus de rigueur qu'aux utilisateurs humains, car un agent peut être manipulé à grande vitesse et à grande échelle. Chaque agent doit disposer de sa propre identité, distincte de celle des utilisateurs et des autres applications, afin que ses actions soient attribuables et ses droits révocables indépendamment.
Deux modèles d'identité coexistent. Dans le premier, l'agent agit avec un compte de service dédié et des permissions fixes. Dans le second, il agit par délégation, au nom de l'utilisateur, avec un jeton limité dans le temps et dans la portée. La délégation est préférable lorsque l'agent accède à des données personnelles, car elle empêche l'agent de voir plus que l'utilisateur lui-même. Notre article sur les politiques d'identité des agents IA approfondit ces choix.
Pour chaque outil, définissez une politique explicite qui précise les actions permises, les paramètres acceptés et les cas nécessitant une validation. Cette politique doit être appliquée par le serveur d'outils, jamais seulement décrite dans le prompt.
{
  "tool": "crm.update_contact",
  "identity": "agent-support-01",
  "allowed_fields": ["phone", "address", "notes"],
  "denied_fields": ["owner", "credit_limit", "role"],
  "max_calls_per_task": 5,
  "requires_human_approval": false
}
Conseil d'expert : recensez les outils de l'agent en deux colonnes, « lecture » et « action ». Toute tâche qui combine une lecture de contenu externe et une action d'écriture ou d'envoi doit passer par une validation humaine ou être scindée en deux agents distincts sans canal direct entre eux.
Les secrets utilisés par les outils, comme les clés d'API et les jetons, ne doivent jamais transiter par le contexte du modèle. Ils restent côté serveur, injectés au moment de l'appel, avec une rotation régulière et une durée de vie courte.
Mémoire, RAG et contexte : empoisonnement et fuite
La mémoire donne à l'agent sa capacité à apprendre des interactions passées, mais elle crée aussi une persistance pour l'attaquant. Une information falsifiée, injectée une seule fois dans la mémoire à long terme ou dans une base documentaire, peut influencer toutes les décisions futures. L'empoisonnement de la mémoire est d'autant plus dangereux qu'il est discret et durable.
Les bases vectorielles utilisées pour la génération augmentée par récupération (RAG) posent un problème similaire. Si n'importe quel collaborateur ou partenaire peut ajouter des documents dans la base consultée par l'agent, il peut y glisser des instructions ou de fausses informations. La provenance de chaque document doit donc être connue, et les sources classées selon leur niveau de confiance.
Plusieurs contrôles réduisent ces risques. Il convient d'enregistrer l'origine et la date de chaque élément mémorisé, de séparer la mémoire par utilisateur et par client pour éviter toute fuite entre périmètres, de fixer une durée d'expiration aux souvenirs non validés et de permettre leur revue et leur suppression. Les droits d'accès aux documents doivent être appliqués au moment de la recherche, afin que l'agent ne récupère jamais un document que l'utilisateur n'a pas le droit de lire.
La fuite de données constitue le revers de la mémoire : un agent qui conserve des informations sensibles peut les restituer à un autre utilisateur ou les intégrer dans une sortie externe. Les attaques visant spécifiquement les pipelines de récupération sont décrites dans notre analyse de l'empoisonnement des bases vectorielles.
MCP et chaîne d'approvisionnement des outils
Le Model Context Protocol standardise la manière dont un agent découvre et appelle des outils. Sa diffusion rapide simplifie l'intégration, mais elle déplace une partie du risque vers la chaîne d'approvisionnement : chaque serveur MCP ajouté étend ce que l'agent peut faire, et chaque description d'outil est un texte lu par le modèle, donc un vecteur potentiel d'injection.
Un serveur d'outils tiers peut être compromis, modifié après son approbation ou volontairement conçu pour exfiltrer des données. Les descriptions d'outils peuvent contenir des instructions cachées qui orientent le modèle vers d'autres outils. La spécification officielle du protocole, disponible sur modelcontextprotocol.io, décrit les mécanismes d'autorisation à mettre en œuvre.
Les bonnes pratiques consistent à maintenir un inventaire des serveurs MCP autorisés, à épingler leurs versions, à relire les descriptions d'outils lors de chaque mise à jour, à exécuter les serveurs locaux dans un environnement isolé et à appliquer une authentification forte sur les serveurs distants. Les risques propres au protocole sont détaillés dans notre guide sur la sécurité du Model Context Protocol.
Le même raisonnement s'applique aux plugins, aux extensions de navigateur utilisées par les agents et aux bibliothèques d'orchestration. Leur intégration doit suivre le processus de validation logicielle de l'organisation, au même titre qu'une dépendance applicative.
Systèmes multi-agents et validation humaine
Les architectures multi-agents, où un agent planificateur délègue à des agents spécialisés, multiplient les échanges et donc les points de manipulation. Un agent compromis peut transmettre des instructions malveillantes à ses pairs, qui les traitent comme des demandes légitimes. Les messages entre agents doivent être authentifiés et traités avec le même niveau de méfiance que les entrées externes.
La validation humaine reste le contrôle le plus robuste pour les actions critiques, à condition d'être bien conçue. Un humain sollicité trop souvent finit par approuver sans lire : c'est la surcharge de validation, que les attaquants peuvent exploiter en multipliant les demandes. Il faut donc réserver la validation aux actions à fort impact et présenter à l'humain un résumé clair de ce qui va être exécuté, avec les paramètres réels.
Une pratique efficace consiste à classer les actions en trois niveaux : actions autonomes, sans impact durable ; actions journalisées et révisables a posteriori ; actions soumises à approbation préalable. Ce classement, établi lors de la modélisation, guide l'implémentation de l'orchestrateur.
Enfin, la non-répudiation impose de pouvoir reconstituer qui a demandé quoi, quel agent a décidé, quel outil a été appelé et avec quels paramètres. Notre article sur la traçabilité des décisions des agents autonomes présente les formats de journalisation adaptés.
Construire la matrice de contrôles de l'agent
La modélisation aboutit à une matrice qui associe chaque scénario de menace retenu à un ou plusieurs contrôles, un responsable et un moyen de vérification. Cette matrice devient la référence partagée entre les équipes de développement, de sécurité et d'exploitation.
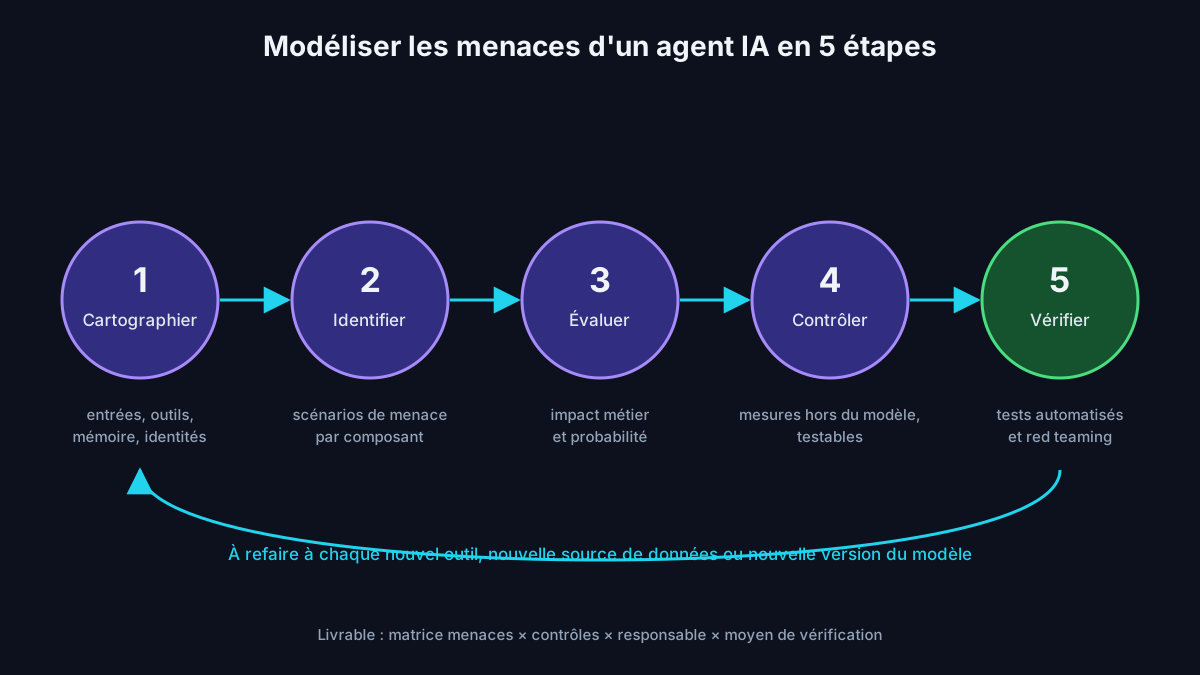
La démarche suit cinq étapes répétables :
- Cartographier l'agent, ses entrées, ses outils, ses stockages et ses identités.
- Identifier les scénarios de menace pour chaque composant à l'aide de la matrice de référence.
- Évaluer chaque scénario selon son impact métier et sa probabilité, en tenant compte des entrées exposées.
- Contrôler en choisissant des mesures appliquées hors du modèle, vérifiables et documentées.
- Vérifier par des tests automatisés et des exercices d'attaque avant chaque mise en production.
Pour être utile, chaque contrôle doit être formulé de manière testable. « L'agent est sécurisé contre l'injection » n'est pas un contrôle ; « l'outil d'envoi de courriel refuse tout destinataire hors du domaine de l'entreprise » en est un. Cette exigence de vérifiabilité facilite les audits et la démonstration de conformité. La checklist sécurité de l'IA agentique fournit une base de contrôles à adapter.
Tester et superviser l'agent en continu
Un agent évolue à chaque modification du modèle, du prompt système, des outils ou des sources de données. Les tests de sécurité doivent donc être intégrés à la chaîne de livraison et rejoués à chaque version. Un jeu de scénarios d'attaque, issu de la matrice de menaces, permet de vérifier automatiquement que les contrôles tiennent.
Ces scénarios couvrent au minimum l'injection indirecte depuis chaque source externe, les tentatives d'appel d'outils hors périmètre, l'extraction du prompt système, la fuite de données entre utilisateurs et le contournement des validations humaines. Les exercices de red teaming des agents autonomes complètent ces tests automatisés par une approche créative.
En production, la supervision s'appuie sur les journaux d'actions de l'agent. Les signaux à surveiller incluent les appels d'outils inhabituels, les volumes anormaux, les destinations externes nouvelles, les refus répétés du serveur d'outils et les écarts entre plan attendu et actions exécutées. Ces événements doivent remonter dans le SIEM de l'organisation avec des règles de détection dédiées.
L'isolement d'exécution réduit enfin les conséquences d'une compromission : conteneurs sans accès réseau superflu, systèmes de fichiers en lecture seule, quotas de ressources. Notre guide sur le sandboxing des agents en production détaille ces mécanismes.
Référentiels et cadre réglementaire à connaître
Plusieurs référentiels structurent la sécurité des agents IA et facilitent la justification des choix réalisés lors de la modélisation. Le NIST AI Risk Management Framework propose une démarche de gestion des risques organisée autour de quatre fonctions : gouverner, cartographier, mesurer et gérer. La cartographie de l'agent décrite dans ce guide s'inscrit directement dans la fonction de cartographie.
Les travaux de l'OWASP fournissent les catalogues de menaces et de contrôles les plus opérationnels pour les équipes techniques. La démarche générale de modélisation des menaces est décrite par la communauté dans la page OWASP Threat Modeling, qui reste applicable aux agents moyennant les catégories spécifiques présentées plus haut.
Sur le plan réglementaire, le règlement européen sur l'intelligence artificielle impose, pour les systèmes à haut risque, une gestion des risques documentée, une journalisation, un contrôle humain et des exigences de robustesse et de cybersécurité. Une modélisation des menaces tenue à jour constitue une pièce centrale de cette documentation. En France, l'ANSSI publie également des recommandations de sécurité pour les systèmes d'IA générative, à consulter lors de la conception.
Les scénarios d'attaque mentionnés dans cet article sont présentés à des fins de conception défensive. Tout test de sécurité doit être réalisé sur des systèmes dont vous avez la responsabilité ou avec une autorisation écrite.
Questions fréquentes
Qu'est-ce que la modélisation des menaces d'un agent IA ?
La modélisation des menaces d'un agent IA est une démarche structurée qui consiste à cartographier les composants de l'agent, ses entrées, ses outils, sa mémoire et ses identités, puis à identifier les scénarios d'abus possibles pour chacun. Elle aboutit à une matrice associant chaque menace retenue à des contrôles vérifiables, un responsable et un moyen de test. Réalisée avant le déploiement, elle permet de prendre les bonnes décisions d'architecture, comme le choix des outils exposés ou le niveau d'autonomie, au moment où elles coûtent le moins cher à modifier. Elle se met à jour à chaque ajout d'outil ou de source de données.
Comment protéger un agent IA contre l'injection de prompt indirecte ?
Aucune technique ne supprime totalement l'injection de prompt indirecte, car le modèle traite instructions et données dans le même texte. La protection repose sur la limitation des conséquences : marquer les contenus externes comme des données, retirer à l'agent les outils inutiles à la tâche, faire valider les plans d'action par un composant déterministe hors du modèle et exiger une confirmation humaine pour les actions sortantes ou irréversibles. Il est aussi recommandé de séparer les agents qui lisent des contenus externes de ceux qui disposent d'outils d'écriture, et de tester ces scénarios à chaque nouvelle version, conformément aux travaux de l'OWASP sur les applications LLM.
Quelles permissions donner à un agent IA en entreprise ?
Un agent IA doit recevoir le minimum de permissions nécessaires à sa tâche, avec une identité propre distincte de celle des utilisateurs. Lorsqu'il accède à des données personnelles, la délégation au nom de l'utilisateur, avec un jeton limité dans le temps et dans la portée, empêche l'agent de voir plus que l'utilisateur lui-même. Chaque outil doit être encadré par une politique appliquée côté serveur, précisant les actions, les champs et les paramètres autorisés. Les secrets restent hors du contexte du modèle, injectés au moment de l'appel et renouvelés régulièrement. Les droits sont revus à chaque évolution fonctionnelle de l'agent.
Le protocole MCP est-il sûr pour connecter des outils à un agent ?
Le Model Context Protocol n'est ni sûr ni dangereux par nature : il standardise la connexion des outils, et sa sécurité dépend de la manière dont il est déployé. Chaque serveur MCP étend les capacités de l'agent, et chaque description d'outil est lue par le modèle, ce qui en fait un vecteur potentiel d'injection. Les bonnes pratiques consistent à tenir un inventaire des serveurs autorisés, à épingler leurs versions, à relire les descriptions à chaque mise à jour, à isoler les serveurs locaux et à imposer une authentification forte aux serveurs distants, comme le prévoit la spécification officielle du protocole.
L'AI Act impose-t-il des exigences de sécurité aux agents IA ?
Le règlement européen sur l'intelligence artificielle classe les systèmes selon leur niveau de risque et non selon leur architecture. Un agent IA utilisé dans un domaine à haut risque, comme le recrutement, le crédit ou certaines infrastructures, doit respecter des obligations de gestion des risques, de journalisation, de contrôle humain, de robustesse et de cybersécurité. Même en dehors du haut risque, ces exigences constituent un cadre de bonnes pratiques pertinent. Une modélisation des menaces documentée et tenue à jour permet de démontrer la maîtrise des risques auprès des auditeurs et des autorités, et facilite la préparation à la conformité.
Conclusion
La sécurité des agents IA repose moins sur la robustesse du modèle que sur la maîtrise de ce que l'agent peut lire, décider et exécuter. En modélisant les menaces avant le déploiement, l'organisation identifie les combinaisons dangereuses entre entrées non fiables et outils puissants, limite le rayon d'impact par des identités et des permissions strictes, et place des validations humaines là où elles ont du sens. La matrice de contrôles qui en résulte sert ensuite de base aux tests, à la supervision et à la démonstration de conformité. Pour approfondir le panorama des risques, consultez notre guide pratique de la sécurité des LLM et des agents.
Vous préparez le déploiement d'un agent IA ?
Ayi NEDJIMI, consultant et pentester certifié, accompagne les équipes dans la modélisation des menaces, la revue d'architecture et les tests de sécurité des agents IA avant leur mise en production.
Demander un accompagnementÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Articles connexes
Attaques contre les agents IA : 5 techniques réelles en 2026
Injection en navigateur agentique, empoisonnement MCP, agents de code, mémoire et zero-click : les 5 techniques d'attaque de 2026 et leurs contre-mesures concrètes.
MCP Registres (Smithery, mcp.run, Cursor) : risques supply chain et vetting
Les registres MCP (Smithery, mcp.run, Cursor) publient des milliers de serveurs sans vérification de sécurité approfondie. Ce guide explique comment auditer un serveur MCP tiers en moins d'une heure et se protéger des attaques supply chain.
Sécuriser un déploiement MCP en production : OAuth 2.1, sandboxing, audit
La sécurisation d'un serveur MCP en production exige OAuth 2.1, sandboxing des processus et logging de tous les tool calls. Ce guide couvre chaque couche de défense avec des exemples de code complets.
Sécurisez vos systèmes d'IA & LLM
Red teaming LLM, audit RAG, détection shadow AI, gouvernance des usages IA en entreprise. Expertise technique et réglementaire (EU AI Act).
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Laisser un commentaire