






Injection en navigateur agentique, empoisonnement MCP, agents de code, mémoire et zero-click : les 5 techniques d'attaque de 2026 et leurs contre-mesures concrètes.
Les attaques contre les agents IA ne relèvent plus de la démonstration de laboratoire : entre 2025 et 2026, des agents en production chez OpenAI, Microsoft, Google ou GitHub ont été détournés par des contenus piégés, des descriptions d'outils falsifiées ou des mémoires empoisonnées. OpenAI a lui-même reconnu que l'injection de prompt dans les navigateurs agentiques ne serait probablement jamais totalement résolue. Cet article passe en revue les cinq familles de techniques documentées publiquement en 2026 : l'injection dans les navigateurs agentiques, l'empoisonnement des outils MCP, le détournement des agents de développement, l'empoisonnement de la mémoire et des hooks, et l'exfiltration zero-click via les connecteurs. Pour chacune, il explique le mécanisme sans détail d'exploitation, cite les cas réels et détaille les contre-mesures concrètes à déployer. Il s'adresse aux RSSI, architectes et équipes SOC qui intègrent des agents dans leur système d'information et complète notre analyse de la surface d'attaque de l'IA agentique.
Résumé exécutif : les cinq techniques d'attaque recensées en 2026 exploitent toutes la même faiblesse : un agent qui lit des contenus non fiables, accède à des données sensibles et dispose d'un canal de sortie. Aucun filtre ne bloque totalement l'injection de prompt. La défense efficace consiste à casser cette combinaison par l'architecture, à restreindre outils et identités, à contrôler les sorties et à superviser chaque action de l'agent.
Points clés de cet article :
- OpenAI reconnaît que l'injection de prompt dans les navigateurs agentiques ne sera probablement jamais entièrement résolue : la défense doit limiter les conséquences.
- Les descriptions d'outils MCP sont lues par le modèle et peuvent cacher des instructions : inventaire, épinglage des versions et revue sont indispensables.
- Les agents de développement peuvent être détournés par un simple titre de pull request ou un commentaire de code.
- La mémoire persistante et les hooks transforment une injection ponctuelle en compromission durable.
- Les attaques zero-click via connecteurs exfiltrent des données sans aucune action de la victime : il faut contrôler les canaux de sortie.
Pourquoi les attaques contre les agents IA explosent en 2026
Un agent IA ne se contente pas de répondre : il lit des pages web, des courriels et des documents, appelle des outils et agit dans des systèmes métier. Chaque nouvelle source de données et chaque nouvel outil élargit ce que l'attaquant peut influencer et ce que l'agent peut faire en son nom. La généralisation des connecteurs, des serveurs Model Context Protocol et des navigateurs agentiques a multiplié ces surfaces en moins de deux ans.
Trifecta létale : expression popularisée par le chercheur Simon Willison pour désigner la combinaison qui rend un agent exploitable pour exfiltrer des données : l'exposition à des contenus non fiables, l'accès à des données privées et la capacité de communiquer vers l'extérieur.
Selon l'analyse de Simon Willison sur la trifecta létale, dès que ces trois éléments sont réunis dans un même agent, un attaquant peut en pratique lui faire divulguer des données, car le modèle ne distingue pas de façon fiable les instructions légitimes des instructions cachées dans les données qu'il traite.
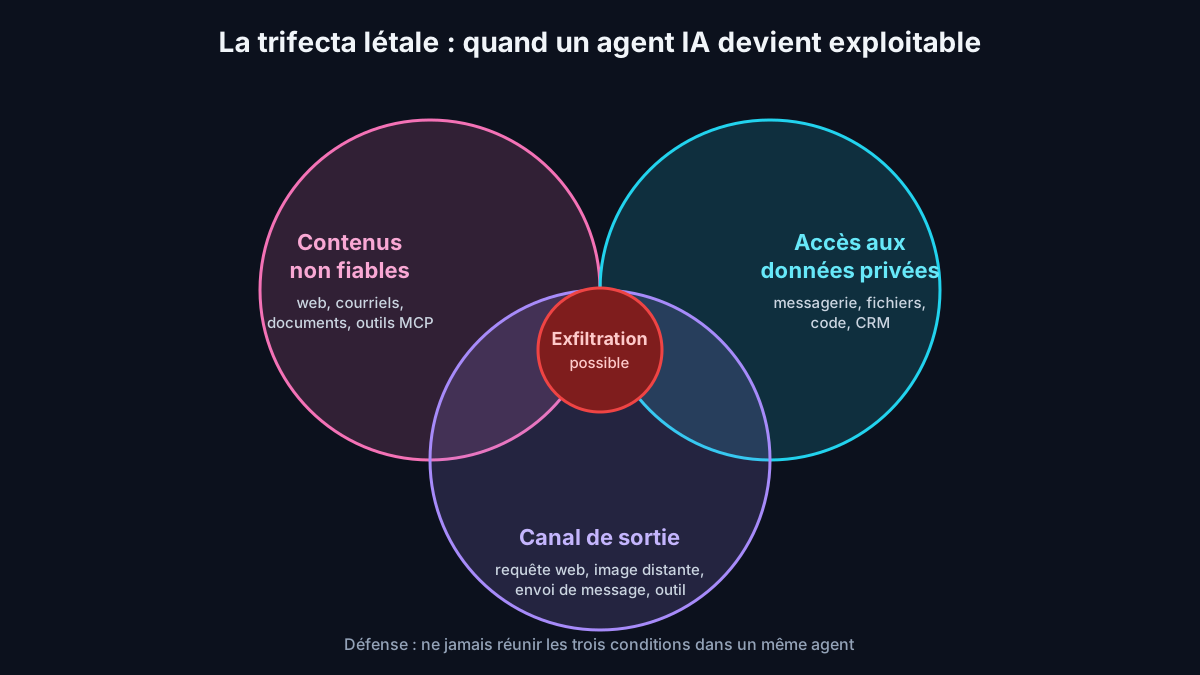
Les cinq familles d'attaques présentées ci-dessous sont autant de manières de réunir ces trois conditions. Les reconnaître permet de comprendre pourquoi les contre-mesures efficaces sont architecturales plutôt que fondées sur la seule détection.
Technique 1 : l'injection de prompt dans les navigateurs agentiques
Les navigateurs agentiques, comme ChatGPT Atlas, naviguent sur le web pour l'utilisateur : ils lisent des pages, remplissent des formulaires et cliquent sur des liens. Chaque page consultée devient une entrée pour le modèle. Un site malveillant ou compromis peut contenir des instructions, visibles ou dissimulées dans le texte, que l'agent risque d'interpréter comme une demande de l'utilisateur.
Le mécanisme ne nécessite aucune vulnérabilité logicielle au sens classique. L'attaquant exploite le fait que le modèle traite le contenu de la page et la consigne de l'utilisateur dans le même flux de texte. Une fois détourné, l'agent peut naviguer vers d'autres sites, divulguer des informations de la session ou effectuer des actions dans des comptes où l'utilisateur est connecté.
OpenAI a publiquement reconnu la difficulté. Comme le rapporte CyberScoop, l'éditeur a indiqué que l'injection de prompt, à l'image des arnaques et de l'ingénierie sociale sur le web, ne serait probablement jamais totalement « résolue ». Il a publié un correctif pour Atlas après qu'un attaquant automatisé fondé sur un modèle, entraîné par apprentissage par renforcement, a découvert une nouvelle classe d'injections que les campagnes de red teaming humaines n'avaient pas identifiée.
Contre-mesures pour les navigateurs agentiques
- Réserver les navigateurs agentiques à des tâches de lecture, sans connexion aux comptes sensibles (messagerie, banque, administration).
- Utiliser un profil de navigation dédié, sans sessions ouvertes ni mots de passe enregistrés.
- Exiger une confirmation explicite avant toute action d'écriture, d'achat ou d'envoi.
- Activer les modes de sécurité renforcée proposés par l'éditeur pour les usages sensibles.
- Restreindre par politique d'entreprise les domaines accessibles à l'agent.
Ce qu'OpenAI a changé : red teaming automatisé et mode verrouillé
La réponse d'OpenAI illustre l'évolution des stratégies de défense chez les éditeurs. Plutôt que de promettre un filtre parfait, l'éditeur combine la recherche automatisée de failles, la réduction des capacités dans les contextes à risque et l'information de l'utilisateur.
Le 13 février 2026, OpenAI a introduit un Lockdown Mode et des étiquettes de risque élevé dans ChatGPT, après avoir admis en décembre 2025 que l'injection de prompt dans les navigateurs IA pourrait ne jamais être entièrement corrigée.
Source : Vectra AI, synthèse sur l'injection de prompt, 2026.
Le principe du mode verrouillé consiste à désactiver ou restreindre les fonctionnalités qui permettent l'exfiltration, comme certains outils ou la consultation de contenus externes, lorsque l'utilisateur traite des informations sensibles. Le red teaming automatisé, lui, permet de rechercher en continu de nouvelles variantes d'attaque à une échelle impossible pour des équipes humaines.
Pour une entreprise, la leçon est double. D'une part, la sécurité d'un agent ne peut pas reposer uniquement sur les protections de l'éditeur du modèle. D'autre part, la réduction des capacités selon le contexte est une mesure efficace que chaque organisation peut appliquer à ses propres agents, comme le détaille notre guide de modélisation des menaces d'un agent IA.
Le cadre de référence s'est également structuré : l'OWASP a publié en décembre 2025 son Top 10 for Agentic Applications 2026, qui place l'injection et le détournement d'objectif au cœur des risques propres aux applications agentiques, dans la continuité des travaux du projet OWASP GenAI Security.
Technique 2 : l'empoisonnement des outils MCP
Le Model Context Protocol permet à un agent de découvrir et d'appeler des outils exposés par des serveurs. Chaque outil est accompagné d'une description en langage naturel que le modèle lit pour savoir quand et comment l'utiliser. Cette description n'est généralement pas affichée à l'utilisateur, ce qui en fait un emplacement idéal pour dissimuler des instructions.
L'attaque, baptisée Tool Poisoning Attack, a été formalisée par Invariant Labs en avril 2025. Un serveur MCP malveillant, ou un serveur légitime compromis, publie des outils dont la description contient, à côté d'une fonction anodine, des consignes invitant le modèle à lire des fichiers sensibles ou à transmettre des données à un autre outil. L'utilisateur voit un outil inoffensif ; le modèle, lui, lit et suit les consignes cachées.
Selon le Cloud Security Alliance, l'équipe de recherche en sécurité de Microsoft a montré le 30 juin 2026 que la modification des descriptions d'outils MCP pouvait conduire un agent à collecter et exfiltrer des données sensibles alors que chaque action individuelle semblait autorisée. Le benchmark académique MCPTox mesure désormais la robustesse des agents face à ces attaques sur des serveurs MCP réels.
Variantes : rug pull et contamination entre serveurs
Deux variantes aggravent le risque. Le rug pull consiste à publier un outil sain, à attendre qu'il soit approuvé, puis à modifier sa description ou son comportement lors d'une mise à jour. La contamination entre serveurs exploite le fait que toutes les descriptions d'outils chargées partagent le même contexte : un serveur malveillant peut influencer la manière dont l'agent utilise les outils d'un autre serveur, pourtant légitime.
Contre-mesures pour les outils MCP
- Tenir un inventaire des serveurs MCP autorisés et interdire l'ajout libre de serveurs par les utilisateurs.
- Épingler les versions des serveurs et relire les descriptions d'outils à chaque mise à jour, avec détection automatique des changements.
- Isoler les agents par périmètre : un agent qui accède à des données sensibles ne doit pas charger de serveurs MCP tiers non audités.
- Exécuter les serveurs locaux dans un environnement isolé, sans accès au système de fichiers ni au réseau au-delà du nécessaire.
- Imposer une authentification forte aux serveurs distants et journaliser chaque appel d'outil avec ses paramètres.
Les risques propres au protocole sont détaillés dans notre guide sur la sécurité du Model Context Protocol et dans notre analyse des injections via les outils MCP.
Technique 3 : le détournement des agents de développement
Les assistants de code agentiques, capables de lire un dépôt, d'exécuter des commandes et de proposer des modifications, sont devenus une cible de choix. Ils traitent en permanence des contenus rédigés par des tiers : issues, pull requests, commentaires, fichiers de documentation, dépendances. Tout ce texte peut porter des instructions.
D'après les recherches compilées par la Cloud Security Alliance, une équipe de l'université Johns Hopkins a montré en avril 2026 qu'il était possible de détourner Claude Code, Gemini CLI et GitHub Copilot en plaçant des instructions malveillantes dans des titres de pull requests GitHub, et que l'attaque était restée indétectée pendant plusieurs semaines dans les environnements concernés. Les mêmes sources signalent que des scanners d'infrastructure publics indexaient début 2026 des serveurs MCP exposés donnant accès à des identifiants et à des historiques de conversation.
L'impact potentiel est élevé, car ces agents s'exécutent souvent avec les droits du développeur : accès au code source, aux secrets de développement, aux jetons de déploiement et parfois aux pipelines d'intégration continue. Un agent détourné peut modifier du code, divulguer des secrets ou introduire une porte dérobée dans une contribution apparemment légitime.
Contre-mesures pour les agents de développement
- Exécuter les agents de code dans un conteneur ou une machine virtuelle dédiée, sans accès aux secrets de production.
- Désactiver l'exécution automatique de commandes et exiger une validation pour toute commande réseau ou d'installation.
- Traiter les issues, pull requests et commentaires externes comme des entrées non fiables, en particulier dans les workflows automatisés.
- Ne jamais donner à un agent déclenché par un événement public des jetons d'écriture sur le dépôt ou des secrets de pipeline.
- Faire relire par un humain toute modification proposée par un agent, comme pour un contributeur externe.
Conseil d'expert : lors des revues de chaînes de développement, le point faible le plus courant n'est pas l'agent lui-même mais le workflow d'intégration continue qui le déclenche automatiquement sur des contenus publics avec des secrets disponibles. Séparer les workflows exposés aux contributions externes de ceux qui manipulent des secrets supprime la majorité du risque.
Technique 4 : l'empoisonnement de la mémoire et des hooks
La mémoire persistante permet à un agent de retenir des préférences et des informations d'une session à l'autre. Elle offre aussi à l'attaquant un moyen de persistance : une instruction injectée une seule fois, par un document ou une page web, peut être enregistrée en mémoire puis influencer toutes les conversations futures, longtemps après la disparition du contenu initial.
Le phénomène a été démontré dès 2024 sur la mémoire de ChatGPT par le chercheur Johann Rehberger, et il fait désormais l'objet de travaux académiques systématiques, comme l'étude Bad Memory publiée en 2026, qui évalue les risques d'injection provenant de la mémoire dans les systèmes agentiques. Une information falsifiée mémorisée peut orienter les décisions de l'agent ou provoquer des fuites répétées.
Les hooks et fichiers de configuration des environnements d'agents constituent une seconde voie de persistance. Ces mécanismes exécutent des actions ou injectent du contexte à des moments précis du fonctionnement de l'agent. Des travaux publiés en 2026 montrent qu'un attaquant capable de contrôler les mises à jour de ces hooks peut orienter durablement un agent vers des comportements malveillants, comme le décrit l'étude sur les mises à jour de hooks contrôlées par un attaquant.
Contre-mesures pour la mémoire et les hooks
- Enregistrer la provenance de chaque élément mémorisé et interdire la mémorisation automatique d'informations issues de contenus externes.
- Permettre à l'utilisateur et aux administrateurs de consulter, auditer et supprimer la mémoire de l'agent.
- Fixer une durée d'expiration aux souvenirs non validés et cloisonner la mémoire par utilisateur et par client.
- Versionner et signer les fichiers de hooks et de configuration, et alerter sur toute modification.
- Désactiver la mémoire persistante pour les agents qui traitent des données sensibles lorsqu'elle n'est pas indispensable.
Les attaques ciblant les sources documentaires des agents sont approfondies dans notre article sur l'injection indirecte et l'empoisonnement RAG.
Technique 5 : l'exfiltration zero-click via les connecteurs
Les attaques les plus redoutées sont celles qui ne demandent aucune action de la victime. Un agent connecté à la messagerie, au stockage de documents ou à l'agenda lit ces contenus dans le cadre de sa tâche normale. Il suffit alors à l'attaquant d'envoyer un courriel ou de partager un document piégé : lorsque l'agent le traite, il exécute les instructions cachées et transmet des données vers l'extérieur.
Plusieurs cas publics de 2025 ont illustré ce scénario. EchoLeak a visé Microsoft 365 Copilot et a fait l'objet de la vulnérabilité CVE-2025-32711, corrigée par Microsoft. AgentFlayer, présenté par Zenity Labs, ciblait les connecteurs de ChatGPT au moyen d'un document partagé piégé. ShadowLeak, décrit par Radware, concernait l'agent de recherche approfondie de ChatGPT connecté à une messagerie, avec une exfiltration réalisée côté serveur, donc invisible pour les outils de sécurité de l'entreprise.
Le canal de sortie est souvent discret : une requête vers une URL contrôlée par l'attaquant, une image distante dont l'adresse contient les données, ou un appel d'outil légitime détourné. C'est pourquoi le contrôle des sorties est aussi important que le contrôle des entrées.
Contre-mesures contre l'exfiltration zero-click
- Limiter les connecteurs actifs au strict nécessaire et appliquer les droits de l'utilisateur lors de chaque accès.
- Bloquer le rendu d'images et de liens vers des domaines externes non approuvés dans les réponses de l'agent.
- Restreindre les requêtes réseau sortantes de l'agent à une liste blanche de destinations.
- Appliquer les étiquettes de confidentialité et les politiques de prévention des fuites de données aux contenus accessibles par l'agent.
- Séparer les agents qui lisent des contenus reçus de l'extérieur de ceux qui accèdent aux données sensibles.
Comparatif des cinq techniques d'attaque
| Technique | Vecteur d'entrée | Interaction victime | Impact principal | Contre-mesure prioritaire |
|---|---|---|---|---|
| Injection en navigateur agentique | Page web consultée | Faible (tâche normale) | Actions dans les comptes connectés | Profil dédié, confirmation des actions |
| Empoisonnement d'outils MCP | Description d'outil | Aucune après installation | Exfiltration via outils légitimes | Inventaire et épinglage des serveurs |
| Détournement d'agent de code | Issue, PR, commentaire | Aucune (workflow automatique) | Fuite de secrets, code piégé | Isolation, absence de secrets |
| Mémoire et hooks | Contenu mémorisé, configuration | Aucune après la première injection | Compromission persistante | Provenance, audit et expiration |
| Zero-click via connecteurs | Courriel, document partagé | Aucune | Exfiltration de données | Contrôle des sorties, cloisonnement |
Ce tableau met en évidence une tendance nette : plus l'agent est intégré au système d'information, moins l'attaque nécessite d'interaction de la victime. Les défenses doivent donc être placées dans l'architecture et non dans la vigilance de l'utilisateur.
Stratégie de défense globale : casser la trifecta létale
Les contre-mesures spécifiques à chaque technique reposent sur des principes communs. Le premier est de ne jamais réunir dans un même agent les trois éléments de la trifecta létale : si un agent doit lire des contenus non fiables, il ne doit ni accéder à des données sensibles ni disposer d'un canal de sortie libre. Cette séparation, décidée à la conception, est plus robuste que n'importe quel filtre.
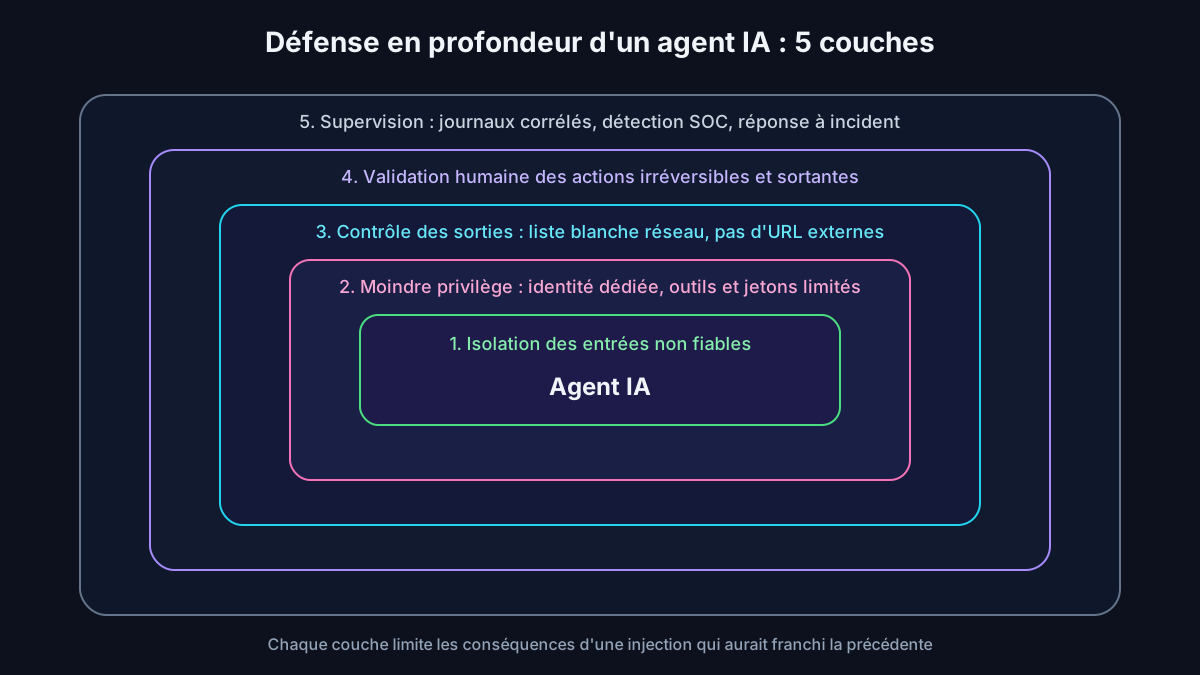
La défense en profondeur d'un agent s'organise en cinq couches complémentaires :
- Isolation des entrées : identifier toutes les sources non fiables et les traiter comme des données, jamais comme des instructions.
- Moindre privilège : identité dédiée à l'agent, permissions minimales par outil, jetons de courte durée, aucun secret dans le contexte du modèle.
- Contrôle des sorties : liste blanche de destinations réseau, blocage du rendu d'URL externes, filtrage des données sensibles.
- Validation humaine : confirmation obligatoire pour les actions irréversibles ou sortantes, avec affichage des paramètres réels.
- Supervision : journalisation de chaque décision et appel d'outil, détection des comportements anormaux et capacité de réponse rapide.
# Politique d'un agent de support (exemple de configuration défensive)
agent: support-client
identite: sa-agent-support          # compte dédié, pas de compte partagé
sources_non_fiables: [courriels_entrants, pieces_jointes]
outils_autorises:
  - crm.lecture
  - ticket.creation
outils_interdits: [messagerie.envoi_externe, fichiers.partage]
sorties_reseau: [api.crm.interne]   # aucune destination externe
validation_humaine: [ticket.cloture, remboursement]
memoire_persistante: false
L'isolation d'exécution complète ce dispositif en limitant ce qu'un agent compromis peut atteindre, comme le détaille notre guide sur le sandboxing des agents en production. La gestion des identités et des droits des agents est approfondie dans notre article sur les politiques d'identité des agents IA.
Détecter une attaque contre un agent IA dans le SOC
Même bien conçu, un agent peut être détourné. La capacité de détection repose sur la qualité des journaux : chaque requête utilisateur, chaque contenu externe traité, chaque appel d'outil et chaque réponse doivent être enregistrés avec un identifiant de corrélation commun, puis transmis au SIEM de l'organisation.
Les signaux d'alerte les plus pertinents sont les suivants :
- Appels d'outils sans rapport avec la tâche demandée ou en volume inhabituel.
- Requêtes sortantes vers des domaines jamais contactés, ou URL contenant des données encodées.
- Lecture de fichiers ou de messages sensibles juste après le traitement d'un contenu externe.
- Modification de la mémoire de l'agent, de ses hooks ou de sa configuration.
- Apparition ou mise à jour d'un serveur MCP, ou changement d'une description d'outil.
Le plan de réponse doit prévoir la suspension immédiate de l'agent, la révocation de ses jetons, l'analyse des journaux pour identifier le contenu déclencheur et la purge de la mémoire contaminée. Les exercices réguliers de red teaming des agents autonomes permettent de vérifier que ces mécanismes fonctionnent avant un incident réel.
Les techniques décrites dans cet article sont présentées à des fins de compréhension et de défense, à partir de recherches publiées. Tout test de sécurité doit être réalisé sur des systèmes dont vous avez la responsabilité ou avec une autorisation écrite.
Questions fréquentes
Peut-on empêcher totalement l'injection de prompt dans un agent IA ?
Non, et OpenAI l'a reconnu publiquement pour les navigateurs agentiques : comme l'ingénierie sociale, l'injection de prompt ne sera probablement jamais entièrement résolue, car le modèle traite instructions et données dans le même texte. La stratégie efficace consiste à limiter les conséquences d'une injection réussie : séparer les agents qui lisent des contenus non fiables de ceux qui accèdent aux données sensibles, restreindre outils et permissions, contrôler les canaux de sortie et exiger une validation humaine pour les actions critiques. Les filtres de détection restent utiles, mais uniquement en complément de ces mesures architecturales.
Qu'est-ce qu'une attaque par empoisonnement d'outils MCP ?
Une attaque par empoisonnement d'outils MCP, ou Tool Poisoning Attack, consiste à dissimuler des instructions malveillantes dans la description d'un outil exposé par un serveur Model Context Protocol. Cette description est lue par le modèle mais rarement affichée à l'utilisateur. Le modèle peut alors être amené à lire des fichiers sensibles ou à transmettre des données via un autre outil, alors que chaque action paraît légitime. Formalisée par Invariant Labs en 2025, cette technique se prévient par un inventaire des serveurs autorisés, l'épinglage des versions, la revue des descriptions et l'isolation des agents sensibles.
Comment fonctionne une attaque zero-click contre un agent IA ?
Une attaque zero-click exploite un agent connecté à des sources de données comme la messagerie ou le stockage de documents. L'attaquant envoie un courriel ou partage un document contenant des instructions cachées. Lorsque l'agent traite ce contenu dans le cadre de sa tâche normale, il suit ces instructions et transmet des données vers l'extérieur, sans aucune action de la victime. Des cas comme EchoLeak dans Microsoft 365 Copilot ou ShadowLeak dans ChatGPT l'ont démontré en 2025. La défense repose sur le contrôle des sorties, la limitation des connecteurs et le cloisonnement des agents.
Quels risques présentent les agents de développement comme Claude Code ou Copilot ?
Les agents de développement lisent en permanence des contenus rédigés par des tiers : issues, pull requests, commentaires et documentation. Des chercheurs ont montré en 2026 qu'un simple titre de pull request pouvait suffire à détourner plusieurs de ces agents. Comme ils s'exécutent souvent avec les droits du développeur, un agent détourné peut divulguer des secrets, modifier du code ou introduire une porte dérobée. Il faut les exécuter dans un environnement isolé, sans secrets de production, désactiver l'exécution automatique de commandes et faire relire chaque modification par un humain.
Pourquoi la mémoire d'un agent IA est-elle un risque de sécurité ?
La mémoire persistante transforme une injection ponctuelle en compromission durable. Une instruction ou une fausse information injectée une seule fois, par exemple via un document, peut être enregistrée et influencer toutes les sessions suivantes, longtemps après la disparition du contenu initial. Des travaux publiés en 2026 évaluent systématiquement ce risque. Les contre-mesures consistent à enregistrer la provenance des éléments mémorisés, à interdire la mémorisation automatique de contenus externes, à fixer des durées d'expiration, à cloisonner la mémoire par utilisateur et à permettre son audit et sa suppression.
Conclusion
Les attaques contre les agents IA documentées en 2025 et 2026 suivent toutes le même schéma : un contenu non fiable influence un agent qui dispose d'accès sensibles et d'un canal de sortie. Navigateurs agentiques, serveurs MCP, agents de développement, mémoires et connecteurs ne sont que des variations de ce thème. Puisque l'injection de prompt ne peut pas être éliminée, la sécurité repose sur l'architecture : casser la trifecta létale, appliquer le moindre privilège, contrôler les sorties, valider les actions critiques et superviser chaque décision. Pour aller plus loin, consultez notre analyse des techniques avancées d'injection de prompt.
Vos agents IA sont-ils exposés ?
Ayi NEDJIMI, consultant et pentester certifié, réalise des revues d'architecture et des tests de sécurité d'agents IA, de serveurs MCP et d'assistants connectés afin d'identifier les chemins d'attaque avant les attaquants.
Demander un audit d'agent IAÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Articles connexes
Sécurité des agents IA : modéliser les menaces avant déploiement
Méthode pas à pas pour modéliser les menaces d'un agent IA : cartographie, injection indirecte, permissions, mémoire, MCP et matrice de contrôles vérifiables.
MCP Registres (Smithery, mcp.run, Cursor) : risques supply chain et vetting
Les registres MCP (Smithery, mcp.run, Cursor) publient des milliers de serveurs sans vérification de sécurité approfondie. Ce guide explique comment auditer un serveur MCP tiers en moins d'une heure et se protéger des attaques supply chain.
Sécuriser un déploiement MCP en production : OAuth 2.1, sandboxing, audit
La sécurisation d'un serveur MCP en production exige OAuth 2.1, sandboxing des processus et logging de tous les tool calls. Ce guide couvre chaque couche de défense avec des exemples de code complets.
Sécurisez vos systèmes d'IA & LLM
Red teaming LLM, audit RAG, détection shadow AI, gouvernance des usages IA en entreprise. Expertise technique et réglementaire (EU AI Act).
Commentaires (1)
Laisser un commentaire