






Comment concevoir et automatiser un test de non-régression fiable : définition, stratégie par le risque, outils, pipeline CI/CD, sécurité et exigences du CRA.
Un test de non-régression vérifie qu'une modification du code, d'une dépendance ou d'une configuration n'a pas cassé ce qui fonctionnait déjà, y compris les correctifs de sécurité passés. C'est la meilleure garantie qu'une vulnérabilité corrigée ne reviendra pas discrètement au détour d'un refactoring : en 2024, la faille regreSSHion d'OpenSSH a montré qu'un correctif de 2006 pouvait disparaître quatorze ans plus tard sans que personne ne s'en aperçoive. En 2026, avec des livraisons quotidiennes, des pipelines CI/CD entièrement automatisés et le Cyber Resilience Act qui exige des tests de sécurité réguliers, la non-régression devient un contrôle de sécurité à part entière, au même titre que l'analyse de code. Ce guide explique comment définir une stratégie, choisir les outils, transformer chaque vulnérabilité en test permanent et l'intégrer dans la chaîne de livraison, dans la continuité de notre article pilier sur la détection as code dans un pipeline CI/CD relié au SIEM.
Résumé exécutif : la non-régression consiste à rejouer, après chaque changement, un ensemble de tests qui protège les comportements déjà validés, qu'ils soient fonctionnels ou liés à la sécurité. Les incidents regreSSHion (CVE-2024-6387) et Channel File 291 de CrowdStrike rappellent qu'un défaut réintroduit ou un cas jamais testé peut toucher des millions de systèmes. Une stratégie efficace combine sélection des tests par le risque, automatisation dans le pipeline, conversion systématique des vulnérabilités corrigées en tests et déploiement progressif. Le Cyber Resilience Act européen fera des tests de sécurité réguliers une obligation pour les fabricants à partir du 11 décembre 2027.
Points clés de cet article :
- Accompagnez chaque correctif de sécurité d'un test automatisé qui échoue sans le correctif et passe avec lui.
- Organisez la suite en niveaux : un socle rapide à chaque merge request, une campagne complète planifiée chaque nuit ou avant chaque release.
- Priorisez les tests par le risque (zones modifiées, fonctions critiques, exposition, historique d'incidents) plutôt que de tout rejouer.
- Traitez les tests instables comme une dette : quarantaine tracée, échéance de correction, jamais pour un test de sécurité.
- Étendez la non-régression aux configurations, aux règles de détection et aux contenus de sécurité, pas seulement au code applicatif.
Test de non-régression : définition et périmètre
Le vocabulaire varie selon les équipes. On parle de test de non-régression, de test de régression ou, en anglais, de regression testing et de non-regression test. Tous désignent la même pratique : rejouer des vérifications déjà réussies pour s'assurer qu'un changement n'a pas dégradé l'existant. Le terme français insiste sur l'objectif visé, l'absence de régression, alors que l'anglais nomme directement le risque que l'on cherche à détecter.
Test de non-régression : test lié au changement, rejoué après une modification du logiciel ou de son environnement, permettant de détecter qu'un défaut a été introduit ou révélé dans une partie qui n'a pourtant pas été modifiée.
Cette définition reprend l'esprit du glossaire officiel de l'ISTQB (International Software Testing Qualifications Board), qui range la non-régression parmi les tests liés aux changements. Le point clé est la notion de zone inchangée : on ne teste pas seulement la fonctionnalité modifiée, on surveille surtout les effets de bord sur tout ce qui l'entoure, y compris les bibliothèques, la configuration et l'infrastructure sous-jacente.
Non-régression, retest et test de confirmation
Le retest, appelé test de confirmation par l'ISTQB, vérifie qu'un défaut précis est bien corrigé : on rejoue le cas qui échouait. Le test de non-régression va plus loin et confirme que la correction n'a rien cassé ailleurs. Les deux sont complémentaires après chaque correctif. Dans une démarche mature, le test de confirmation d'une vulnérabilité devient ensuite un membre permanent de la suite de non-régression, exécuté pendant toute la vie du produit.
Ce qui déclenche une campagne
Une campagne de non-régression se justifie dès que l'un des éléments suivants change, même lorsque la modification paraît anodine ou purement technique :
- le code applicatif : nouvelle fonctionnalité, correctif, refactoring, montée de version du langage ;
- une dépendance ou une image de base : bibliothèque, runtime, image de conteneur ;
- la configuration : paramètres de serveur, règles de pare-feu, politiques IAM, fichiers de déploiement ;
- l'environnement : système d'exploitation, version de base de données, service cloud managé ;
- un contenu de sécurité : signatures, règles de détection, listes de blocage, politiques WAF.
Pourquoi la non-régression est aussi un contrôle de sécurité
Une régression fonctionnelle gêne les utilisateurs ; une régression de sécurité rouvre une porte que l'on croyait fermée. Le danger tient à son invisibilité : l'application fonctionne normalement, les tests métier passent, mais un contrôle d'accès, une validation d'entrée ou un traitement de signal a disparu. Seul un test explicitement conçu pour vérifier la propriété de sécurité peut détecter ce retour en arrière avant qu'un attaquant ne le découvre.
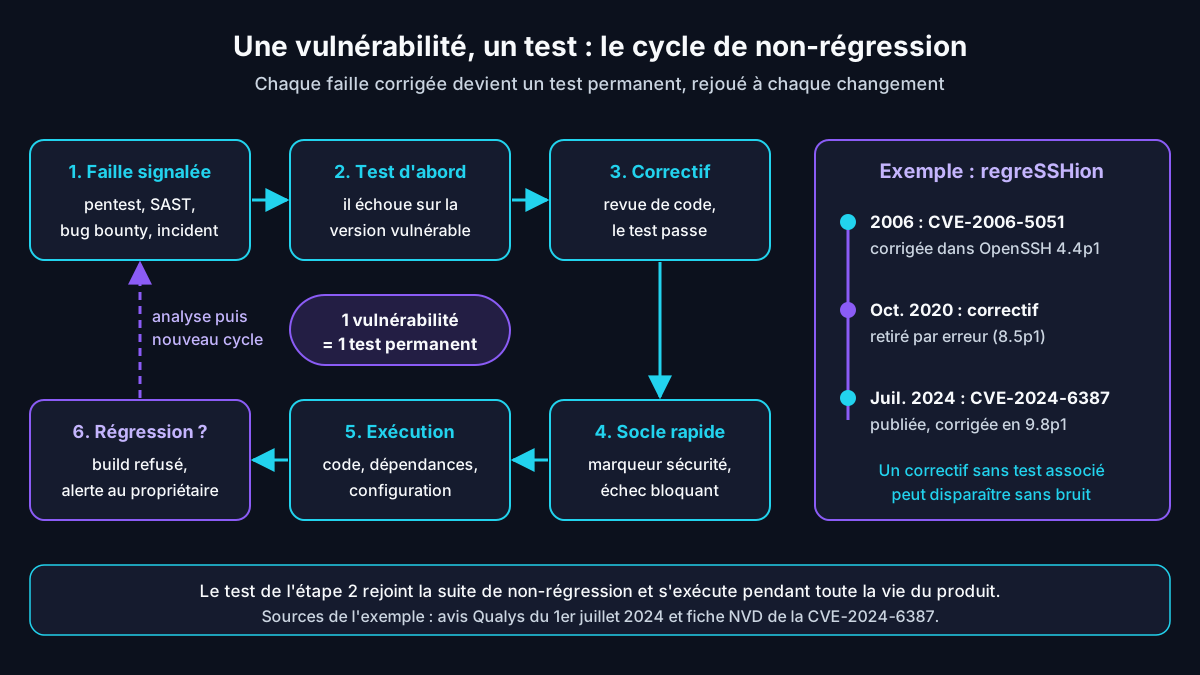
regreSSHion : un correctif de 2006 perdu en 2020
La fiche NVD de la CVE-2024-6387 la décrit comme une régression de sécurité de la CVE-2006-5051 dans le serveur sshd d'OpenSSH : une condition de concurrence dans la gestion des signaux, déclenchable à distance sans authentification. Le score CVSS 3.1 retenu par le NIST est de 8,1. Sur les systèmes Linux reposant sur glibc, l'exploitation peut aboutir à une exécution de code avec les privilèges root.
L'avis technique publié par Qualys le 1er juillet 2024 détaille l'origine du problème. Un commit d'octobre 2020, intégré à OpenSSH 8.5p1 pour remanier l'infrastructure de journalisation, a supprimé par accident une directive de compilation conditionnelle qui rendait la fonction sigdie() sûre. Les versions 4.4p1 à 8.4p1 étaient protégées ; les versions 8.5p1 à 9.7p1 sont redevenues vulnérables jusqu'à la sortie de la 9.8p1.
La leçon dépasse OpenSSH : un correctif de sécurité sans test automatisé associé peut être annulé par n'importe quel refactoring, même dans un projet réputé pour sa rigueur. Un test vérifiant que le gestionnaire de signal n'appelle que des fonctions sûres aurait pu transformer cette régression silencieuse en simple échec de build, près de quatre ans avant sa découverte publique.
Channel File 291 : le cas que personne n'avait testé
Le 19 juillet 2024, une mise à jour de contenu du capteur Falcon de CrowdStrike a provoqué l'arrêt brutal de machines Windows dans le monde entier. L'analyse de cause racine publiée par l'éditeur en août 2024 explique qu'un type de modèle déclarait 21 champs d'entrée alors que le code d'intégration n'en fournissait que 20. Ce décalage a échappé à plusieurs couches de validation et de tests.
La raison est instructive pour toute équipe de test. Les tests automatisés reposaient sur un jeu statique de douze cas, et le fichier de contenu utilisé pour ces tests plaçait un critère générique (joker) sur le 21e champ de toutes les instances : le chemin de code défaillant n'était donc jamais exercé. Parmi les mesures correctives annoncées figurent des tests automatisés avec des critères non génériques pour chaque champ, le test de chaque nouvelle instance de contenu, du fuzzing et un déploiement progressif par anneaux.
Chiffre clé : Microsoft estimait le 20 juillet 2024 que la mise à jour défectueuse de CrowdStrike avait touché 8,5 millions d'appareils Windows, soit moins de 1 % du parc Windows mondial, avec des conséquences économiques et sociales importantes en raison des services critiques concernés. Source : blog officiel de Microsoft, 20 juillet 2024.
Ces deux incidents ont un point commun : aucun ne résulte d'une attaque, tous deux proviennent d'un cas que la couverture de tests ne protégeait pas. Ce type de lacune rejoint les faiblesses décrites dans notre article CI/CD : l'angle mort de la sécurité DevOps, où la vitesse de livraison progresse plus vite que les contrôles qui l'encadrent.
Les familles de tests de non-régression informatique
Un test de non-régression informatique n'est pas un type de test en soi : c'est un usage. N'importe quel test automatisé et déterministe peut rejoindre la suite de non-régression, à condition qu'il protège un comportement attendu. Le tableau suivant compare les principales familles selon ce qu'elles vérifient, leur fréquence d'exécution typique, leur coût de maintenance et quelques outils courants.
| Famille | Ce qu'elle vérifie | Fréquence recommandée | Coût de maintenance | Exemples d'outils |
|---|---|---|---|---|
| Tests unitaires | Fonctions isolées, règles de validation, cas limites | Chaque commit | Faible | pytest, JUnit, Jest |
| Tests d'intégration et d'API | Contrats entre services, codes HTTP, contrôles d'accès | Chaque merge request | Moyen | pytest et requests, Newman, REST Assured |
| Tests de bout en bout | Parcours utilisateur complets dans le navigateur | Quotidienne ou avant release | Élevé | Playwright, Cypress, Selenium |
| Tests de sécurité automatisés | Failles déjà corrigées, en-têtes, dépendances vulnérables | Chaque merge request et chaque nuit | Moyen | Semgrep, ZAP, Trivy |
| Tests de performance | Temps de réponse, consommation de ressources | Avant release | Moyen à élevé | k6, Gatling, JMeter |
| Tests de configuration | Durcissement, versions de paquets, infrastructure as code | Chaque changement d'infrastructure | Faible à moyen | Testinfra, Checkov, InSpec |
| Tests de règles de détection | Déclenchement attendu des alertes SIEM ou EDR | Chaque modification de règle | Moyen | Journaux de référence, règles Sigma |
La pyramide des tests reste un bon repère : beaucoup de tests unitaires rapides, moins de tests d'intégration, peu de tests de bout en bout. Pour la non-régression, cette répartition a un effet direct sur le délai de retour. Une suite dominée par l'interface graphique devient vite trop lente pour être lancée à chaque modification, et les équipes finissent par la contourner ou par l'exécuter trop rarement.
Régressions fonctionnelles, de performance et de sécurité
On distingue trois natures de régression. La régression fonctionnelle modifie un résultat attendu, par exemple un calcul de remise. La régression de performance dégrade un temps de réponse ou une consommation mémoire sans erreur visible. La régression de sécurité supprime ou affaiblit un contrôle : authentification, autorisation, chiffrement, validation d'entrée, journalisation. Cette dernière est la plus coûteuse, car elle ne produit généralement aucun symptôme pour l'utilisateur légitime.
Construire une stratégie de test de non-régression
Rejouer l'intégralité des tests à chaque modification, l'approche dite retest all, est sûr mais devient vite intenable lorsque la suite dépasse quelques milliers de cas. Une stratégie efficace répond à trois questions : quoi tester, quand le tester et avec quel niveau d'exigence pour bloquer une livraison. La réponse doit être écrite, versionnée avec le code et revue comme n'importe quelle politique de sécurité.
Sélectionner les tests par l'analyse d'impact
La sélection de tests de régression consiste à ne lancer que les cas susceptibles d'être affectés par un changement. Les techniques vont de la simple correspondance entre répertoires modifiés et suites associées jusqu'à l'analyse de couverture, qui relie chaque test aux fichiers qu'il exerce. Des extensions comme pytest-testmon ou les commandes « affected » des outils de monorepo automatisent ce tri. Une règle s'impose toutefois : les tests de sécurité critiques ne sont jamais exclus par la sélection.
Prioriser par le risque
Lorsque le temps est contraint, l'ordre d'exécution compte autant que la sélection. Une priorisation simple et défendable devant un auditeur classe les tests selon les critères suivants, du plus important au moins important :
- Criticité de la fonction couverte : authentification, paiement, données personnelles, administration.
- Proximité avec le code modifié, mesurée par la couverture ou le graphe de dépendances.
- Historique : les zones déjà touchées par des incidents ou des vulnérabilités méritent une surveillance renforcée.
- Exposition : les fonctions accessibles depuis Internet passent avant les fonctions internes.
- Durée : à risque égal, le test le plus rapide s'exécute en premier pour accélérer le retour au développeur.
Définir les critères de blocage
Une porte de qualité (quality gate) est un seuil automatique qui autorise ou bloque la progression d'un artefact dans le pipeline. Pour la non-régression, la règle la plus robuste est binaire : tout échec d'un test marqué sécurité bloque la fusion, sans dérogation possible hors procédure d'exception tracée et validée. Les échecs de tests fonctionnels non critiques peuvent, eux, relever d'une décision humaine documentée dans le ticket de livraison.
Transformer chaque vulnérabilité corrigée en test permanent
Le réflexe le plus rentable d'une équipe DevSecOps consiste à écrire, pour chaque vulnérabilité remontée par un pentest, un programme de bug bounty ou une alerte SAST (analyse statique), un test qui échoue tant que la faille est présente. Le test est rédigé avant le correctif, ce qui prouve qu'il détecte réellement le problème, puis il rejoint la suite de non-régression et s'exécute pour toute la vie du produit.
Cadre d'usage : les tests de sécurité décrits dans cette section vérifient des contrôles défensifs sur vos propres applications, dans des environnements dont vous êtes responsable. Toute vérification sur un système tiers exige une autorisation écrite et un périmètre défini ; un accès frauduleux à un système de traitement automatisé de données est sanctionné par l'article 323-1 du Code pénal.
Anatomie d'un test de non-régression de sécurité
Un bon test de sécurité régressif reste volontairement modeste : il ne cherche pas à exploiter la faille, il vérifie la réponse du système. Il comporte en général les éléments suivants :
- un identifiant qui relie le test au ticket ou à l'avis de sécurité d'origine ;
- une reproduction minimale du scénario, sans charge offensive inutile ;
- une assertion sur la propriété attendue : refus d'accès, rejet d'une entrée, en-tête présent ;
- un marqueur qui l'inclut dans le socle rapide du pipeline ;
- un propriétaire identifié, chargé de le maintenir lorsque l'application évolue.
L'exemple suivant illustre ce schéma avec pytest sur une API web de recette. Il vérifie qu'un client authentifié ne peut pas consulter la facture d'un autre client, une faille de type IDOR (référence directe non sécurisée à un objet) corrigée après un audit, et qu'un point d'administration refuse les requêtes anonymes. Les fixtures de session sont définies dans le fichier conftest.py du projet.
import os
import pytest
import requests

BASE_URL = os.environ["STAGING_URL"]

@pytest.mark.regression_securite
def test_sec_2026_014_idor_facture(session_client_a, facture_client_b):
    """SEC-2026-014 : un client ne doit jamais lire la facture d'un autre."""
    r = session_client_a.get(f"{BASE_URL}/api/factures/{facture_client_b}")
    assert r.status_code in (403, 404)
    assert "montant" not in r.text

@pytest.mark.regression_securite
def test_sec_2026_021_admin_anonyme_refuse():
    """SEC-2026-021 : l'API d'administration exige une authentification."""
    r = requests.get(f"{BASE_URL}/api/admin/utilisateurs", timeout=10)
    assert r.status_code == 401
Conseil d'expert : nommez chaque test d'après l'identifiant de la vulnérabilité et reliez-le au rapport d'audit. Lors d'un audit de suivi, la preuve de non-réapparition devient une simple requête dans l'historique du pipeline : quels tests de sécurité ont été exécutés, sur quelle version, avec quel résultat. C'est aussi un argument solide face à un client ou à un auditeur qui demande comment les écarts passés sont maîtrisés dans la durée.
Ces tests ne remplacent pas les analyses outillées. Ils complètent la chaîne décrite dans notre audit de sécurité d'un pipeline CI/CD avec SAST, DAST et SCA : les scanners détectent des classes de défauts connues, tandis que le test de non-régression garantit qu'un défaut spécifique, déjà identifié et payé une fois, ne reviendra pas dans une version ultérieure.
Intégrer les tests de non-régression dans le pipeline CI/CD
L'intégration continue (CI) n'a de valeur que si les tests s'exécutent automatiquement et rapidement. La pratique courante consiste à étager la suite : un socle court sur chaque merge request, une campagne complète planifiée la nuit et une validation renforcée avant chaque mise en production. Chaque étage dispose de son budget de temps et de ses critères de blocage, ce qui évite que la lenteur pousse les développeurs à désactiver les contrôles.
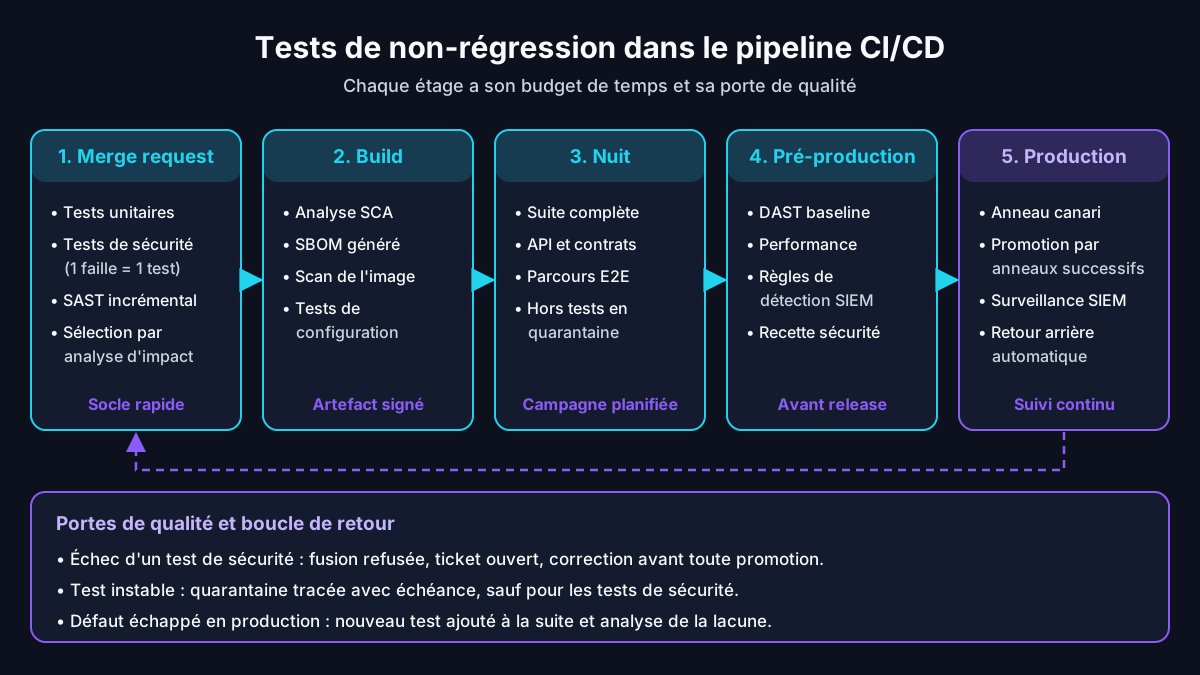
Exemple de workflow étagé
Le fichier GitHub Actions ci-dessous illustre cette séparation : un job rapide sur chaque pull request, limité aux tests unitaires et aux tests de sécurité marqués, et un job complet déclenché chaque nuit qui exclut seulement les tests placés en quarantaine. La même logique se transpose sans difficulté à GitLab CI, Jenkins ou Azure Pipelines, avec des marqueurs ou des étiquettes équivalents.
name: non-regression
on:
  pull_request:
  schedule:
    - cron: "0 2 * * *"
jobs:
  socle-rapide:
    if: github.event_name == 'pull_request'
    runs-on: ubuntu-24.04
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - run: pip install -r requirements-test.txt
      - run: pytest -m "unit or regression_securite" -q
  campagne-complete:
    if: github.event_name == 'schedule'
    runs-on: ubuntu-24.04
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.12"
      - run: pip install -r requirements-test.txt
      - run: pytest -m "not quarantaine" --junitxml=rapport.xml
Pour l'architecture globale du pipeline, la gestion des secrets et le durcissement des runners, reportez-vous à notre guide complet du pipeline CI/CD sécurisé. Les tests de non-régression ne valent que si le pipeline qui les exécute est lui-même protégé contre la falsification : un acteur capable de modifier un workflow peut tout simplement retirer la suite du chemin bloquant.
Déploiement progressif : prolonger la non-régression en production
Aucune suite de tests ne reproduit parfaitement la production. Le déploiement progressif prolonge donc la non-régression : la nouvelle version est d'abord servie à un anneau restreint, dit canari, surveillée sur des indicateurs d'erreur et de sécurité, puis promue ou annulée automatiquement. C'est l'une des mesures retenues par CrowdStrike après l'incident Channel File 291 de juillet 2024 pour ses mises à jour de contenu, avec des anneaux successifs et un temps d'observation entre chaque promotion.
Outil de test de non-régression : critères de choix
Il n'existe pas d'outil de test de non-régression universel : le choix dépend du langage, du type d'application et de la maturité de l'équipe. La plupart des organisations combinent un framework de tests propre à leur langage, un outil d'automatisation d'interface ou d'API et des scanners de sécurité intégrés au même pipeline. L'essentiel est que tous produisent des résultats exploitables par la CI, généralement au format JUnit XML.
Les critères qui comptent vraiment
- Intégration CI/CD : exécution en ligne de commande, codes de retour fiables, rapports standard.
- Parallélisation et exécution sélective, pour tenir le budget de temps du socle rapide.
- Gestion des données de test : fixtures, jeux anonymisés, environnements éphémères.
- Stabilité : attentes explicites pour les tests d'interface afin de limiter les faux échecs.
- Traçabilité entre test, exigence et ticket, indispensable en contexte réglementé.
- Coût total : licences, mais surtout temps de maintenance des scripts sur plusieurs années.
Panorama par usage
Pour les tests unitaires et d'API, les frameworks natifs restent la référence : pytest en Python, JUnit en Java, Jest ou Vitest en JavaScript. Pour les parcours web, Playwright et Cypress se sont imposés à côté de Selenium, plus ancien mais toujours très répandu. Côté sécurité, on retrouve souvent Semgrep pour l'analyse statique, ZAP en mode baseline pour l'analyse dynamique et Trivy pour les dépendances et les images de conteneurs.
Les plateformes commerciales de gestion de tests ou d'automatisation sans code peuvent accélérer le démarrage d'équipes peu outillées. Leur intérêt doit cependant être évalué sous l'angle de la réversibilité : des scripts enfermés dans un format propriétaire deviennent une dette le jour où l'outil ne convient plus. Privilégiez des formats ouverts et des tests versionnés dans le même dépôt que le code qu'ils protègent.
Non-régression des règles de détection et du SIEM
La non-régression ne concerne pas que les applications. Les équipes d'un SOC (centre opérationnel de sécurité) modifient en permanence leurs règles de détection, leurs parseurs et leurs tables d'enrichissement. Un changement de format de journal, une mise à jour d'agent ou une optimisation de requête peut rendre une règle muette sans aucune erreur visible. Le résultat est le pire des scénarios : un angle mort que personne ne remarque avant l'incident.
L'approche detection as code, qui gère la détection comme du code, répond à ce risque. Chaque règle est versionnée, revue et accompagnée de journaux de référence qui doivent la déclencher, ainsi que d'exemples légitimes qui ne doivent pas la déclencher. Le pipeline rejoue ces jeux à chaque modification. Notre article pilier sur la chaîne detection as code entre CI/CD et SIEM détaille cette architecture pas à pas.
L'incident Channel File 291 illustre la même logique côté éditeur : un contenu de sécurité, composé de critères de détection et non de code compilé, a suffi à provoquer une panne massive. Les contenus de sécurité méritent donc la même rigueur que le code : tests sur tous les champs, cas limites, données réalistes et déploiement progressif avant toute diffusion générale.
Que tester sur une règle de détection ?
- le vrai positif : un échantillon d'activité malveillante simulée ou issue d'un incident passé doit produire l'alerte ;
- le vrai négatif : une activité d'administration légitime ne doit pas la déclencher ;
- la robustesse au format : variantes de champs, encodages, journaux tronqués ;
- la performance de la requête sur un volume de données représentatif ;
- la cohérence avec la technique MITRE ATT&CK documentée dans les métadonnées de la règle.
Tests instables, dette et coûts : garder une suite fiable
Un test instable, ou flaky test, passe ou échoue sans changement du code testé, à cause d'une dépendance réseau, d'une condition de concurrence ou de données partagées. Quelques tests de ce type suffisent à ruiner la confiance : les développeurs relancent le pipeline jusqu'à obtenir du vert, puis finissent par ignorer les échecs réels. Pour un test de sécurité, cette accoutumance est particulièrement dangereuse.
Une politique de quarantaine explicite
La quarantaine consiste à retirer temporairement un test instable du chemin bloquant, sans le supprimer, avec un ticket et une échéance de correction. Les tests de sécurité doivent faire exception : un test de sécurité instable reste bloquant et sa correction devient prioritaire. Sans échéance ni suivi, la quarantaine se transforme en cimetière de tests et la couverture réelle diminue en silence, release après release.
Indicateurs pour piloter une suite de non-régression
Quelques indicateurs suffisent à piloter une suite de non-régression : durée du socle rapide, taux d'échecs non reproductibles, nombre de tests en quarantaine et ancienneté, part des vulnérabilités corrigées couvertes par un test dédié, défauts échappés en production malgré la suite. Ce dernier indicateur est le plus honnête : chaque défaut échappé devrait produire un nouveau test et une analyse de la lacune qui l'a laissé passer.
La couverture de code ne mesure pas à elle seule la qualité d'une suite de non-régression : l'incident CrowdStrike montre qu'un code peut être exécuté par des tests sans que le cas dangereux soit jamais exercé. Le test de mutation, qui modifie volontairement le code pour vérifier que les tests le détectent, donne une meilleure idée de la capacité réelle de détection, au prix d'un temps de calcul plus élevé.
Cadre réglementaire : ce que le Cyber Resilience Act change
Le règlement (UE) 2024/2847, dit Cyber Resilience Act, fixe des exigences de cybersécurité pour les produits comportant des éléments numériques mis sur le marché européen. Son annexe I, partie II, consacrée à la gestion des vulnérabilités, demande notamment aux fabricants d'appliquer des tests et des revues de sécurité efficaces et réguliers, de documenter les composants dans une nomenclature logicielle (SBOM) et de corriger les vulnérabilités sans délai.
Le calendrier est échelonné. Les obligations de signalement des vulnérabilités activement exploitées et des incidents graves, prévues à l'article 14, s'appliquent depuis le 11 septembre 2026, et l'ensemble des exigences essentielles s'appliquera à partir du 11 décembre 2027. Pour un éditeur, une suite de non-régression de sécurité traçable constitue une preuve concrète et datée de ces tests réguliers, mobilisable lors d'une évaluation de conformité.
Le texte prévoit aussi que, lorsque c'est techniquement possible, les mises à jour de sécurité soient distribuées séparément des mises à jour fonctionnelles. Cette séparation n'a de sens que si un correctif publié en urgence est lui-même validé par une campagne de non-régression courte et fiable. L'articulation avec l'inventaire des composants est détaillée dans notre article sur SBOM et SCA en CI/CD en 2026.
ISO 27001 et DORA : d'autres référentiels exigent ces tests
Le Cyber Resilience Act n'est pas le seul texte à exiger des tests de sécurité réguliers. La norme ISO/IEC 27001:2022 consacre une mesure de son annexe A aux tests de sécurité pendant le développement et la recette (mesure 8.29), et le règlement DORA impose aux entités financières un programme de tests de résilience opérationnelle numérique. Dans tous les cas, l'auditeur attend la même chose : des tests définis, exécutés régulièrement et dont les résultats sont conservés.
Mettre en place la démarche en 90 jours
Une démarche progressive évite l'effet tunnel et produit des gains de sécurité visibles dès les premières semaines. Le plan suivant, adapté aux équipes qui partent d'une suite de tests partielle, privilégie la couverture des failles connues avant l'exhaustivité fonctionnelle.
- Semaines 1 à 2 : inventorier les tests existants, mesurer la durée du pipeline et lister les vulnérabilités corrigées au cours des deux dernières années.
- Semaines 3 à 4 : écrire un test de non-régression pour chaque vulnérabilité critique ou élevée de cette liste, en commençant par les fonctions exposées sur Internet.
- Semaines 5 à 6 : séparer socle rapide et campagne complète, introduire les marqueurs et rendre bloquante la porte de qualité des tests de sécurité.
- Semaines 7 à 9 : traiter les tests instables, instaurer la quarantaine avec échéance, ajouter les tests de configuration et de dépendances.
- Semaines 10 à 13 : étendre la démarche aux règles de détection et au déploiement progressif, puis inscrire la règle « une vulnérabilité, un test » dans la définition de terminé.
Environnement de test : démarche et exemples reproduits en lab isolé sur Debian 12 (Python 3.11, pytest 8), avec un runner GitHub Actions auto-hébergé, une API Flask de démonstration volontairement vulnérable puis corrigée, ZAP en mode baseline et Trivy sur l'image de conteneur. Aucun système tiers n'a été testé ; les durées d'exécution dépendent fortement du contexte et ne sont pas extrapolables à une autre organisation.
Retour terrain : Cas typique rencontré en mission — lors d'un test d'intrusion de contrôle, je retrouve régulièrement une vulnérabilité pourtant corrigée après l'audit précédent, souvent un défaut de contrôle d'autorisation sur une API. Le correctif a été écrasé lors d'une fusion de branches ou d'une refonte du module ; aucun test ne le protégeait, et la régression est restée en production, inaperçue jusqu'à l'audit suivant. La mesure qui règle durablement le problème : chaque constat du rapport donne lieu à un test automatisé bloquant dans le pipeline, rattaché à la référence du constat.
Gardez enfin en tête que la suite de tests fait partie de la surface d'attaque de la chaîne logicielle. Les techniques décrites dans notre analyse des attaques APT contre les pipelines CI/CD et la supply chain visent justement les workflows, les runners et les secrets : protéger la non-régression, c'est aussi protéger l'intégrité du pipeline qui l'exécute.
À lire aussi : le coût d'un correctif non déployé.
Questions fréquentes
Quelle est la différence entre test de régression et test de non-régression ?
Il n'y a pas de différence de fond. « Test de régression » est la traduction directe de l'anglais regression testing, tandis que « test de non-régression » est l'usage dominant en France et insiste sur l'objectif recherché : l'absence de régression. Les deux désignent des tests rejoués après une modification pour vérifier que les parties inchangées du logiciel fonctionnent toujours. La distinction utile oppose plutôt la non-régression au test de confirmation, ou retest, qui vérifie seulement qu'un défaut précis est corrigé. Après un correctif, on exécute d'abord le test de confirmation, puis la suite de non-régression pour détecter les effets de bord. Dans une démarche DevSecOps, le test de confirmation d'une vulnérabilité rejoint ensuite cette suite.
Quand faut-il lancer des tests de non-régression ?
À chaque changement susceptible d'affecter le comportement du système : modification du code, mise à jour d'une dépendance, changement de configuration, migration d'infrastructure ou nouvelle version d'un contenu de sécurité. En pratique, on étage les exécutions. Un socle rapide de quelques minutes tourne sur chaque merge request et comprend les tests unitaires et les tests de sécurité critiques. Une campagne complète tourne chaque nuit ou avant chaque release. Un contrôle ciblé accompagne enfin chaque correctif urgent, car c'est justement dans la précipitation que les régressions se glissent. Les mises à jour de bibliothèques proposées automatiquement par des robots doivent passer par le même pipeline que le code écrit par l'équipe.
Peut-on automatiser entièrement les tests de non-régression ?
On peut automatiser la grande majorité des vérifications répétitives, et c'est souhaitable : un test de non-régression manuel est rarement rejoué assez souvent pour être utile. Certaines vérifications restent difficiles à automatiser de façon fiable, comme l'ergonomie, certains rendus visuels complexes ou des scénarios dépendant de matériels spécifiques. Pour la sécurité, l'automatisation couvre bien les contrôles d'accès, la validation des entrées, les en-têtes HTTP, les dépendances vulnérables et la configuration. Elle ne remplace pas un test d'intrusion périodique, qui cherche des failles nouvelles, alors que la non-régression vérifie que les failles connues ne reviennent pas. Les deux approches sont complémentaires et s'alimentent mutuellement.
Quel outil de test de non-régression choisir ?
Le bon outil dépend d'abord de votre pile technique. Pour les tests unitaires et d'API, utilisez le framework natif du langage : pytest, JUnit, Jest ou Vitest. Pour les parcours web, Playwright et Cypress sont des choix courants, Selenium restant pertinent pour des besoins multinavigateurs historiques. Pour la sécurité, combinez un analyseur statique, un scanner dynamique comme ZAP et un outil d'analyse de composants comme Trivy. Les critères décisifs sont l'exécution en ligne de commande dans la CI, la production de rapports standard, la parallélisation, la gestion des données de test et la réversibilité. Évitez de multiplier les outils : une pile réduite et maîtrisée vaut mieux qu'un catalogue mal entretenu.
Comment éviter qu'une faille corrigée réapparaisse ?
Appliquez la règle « une vulnérabilité, un test ». Pour chaque faille corrigée, écrivez un test automatisé qui reproduit le scénario de manière minimale et vérifie la propriété de sécurité attendue, par exemple un refus d'accès ou le rejet d'une entrée. Faites-le échouer sur la version vulnérable pour prouver qu'il détecte le problème, puis intégrez-le au socle rapide du pipeline avec un échec bloquant. Reliez-le au ticket d'origine pour la traçabilité. Le cas regreSSHion, régression d'une faille OpenSSH corrigée en 2006 puis réintroduite en 2020, montre que ce risque existe même dans les projets les plus rigoureux et qu'un correctif sans test peut disparaître lors d'un simple remaniement.
Conclusion
Le test de non-régression est souvent présenté comme une affaire de qualité logicielle. Les incidents regreSSHion et Channel File 291 montrent qu'il s'agit aussi d'un contrôle de sécurité de premier ordre : un correctif non protégé par un test peut disparaître, et un cas jamais exercé peut paralyser des millions de postes. La différence se joue moins sur le choix de l'outil que sur la discipline appliquée à chaque changement.
Quatre pratiques font l'essentiel du résultat : un test par vulnérabilité corrigée, une suite étagée qui respecte le budget de temps des développeurs, une quarantaine stricte pour les tests instables et un déploiement progressif qui prolonge la vérification en production. Pour aller plus loin, consultez notre livre blanc sur la sécurité DevSecOps dans le CI/CD et notre article pilier consacré à la detection as code et au SIEM.
Fiabiliser vos tests de non-régression de sécurité
Ayi NEDJIMI audite les pipelines CI/CD, transforme les résultats de pentest en tests automatisés et aide les équipes à bâtir une stratégie de non-régression adaptée à leurs risques comme à leurs obligations réglementaires.
Discuter de votre pipelineÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Testez vos connaissances
Mini-quiz de certification lié à cet article — propulsé par CertifExpress
Articles connexes
ModSecurity en 2026 : WAF open source, OWASP CRS et php2shell
ModSecurity sous la garde de l'OWASP : choisir entre v2, v3 et Coraza, régler le CRS, corriger l'erreur Response body too large et réagir face à php2shell.
SBOM SCA CI/CD sécurité 2026 : intégration complète
SBOM et SCA intégrés dans vos pipelines CI/CD en 2026 : inventoriez, analysez et sécurisez vos dépendances open source contre les attaques supply chain.
API Security 2026 : Sécuriser GraphQL, REST et Serverless
Les APIs GraphQL, REST et Serverless concentrent en 2026 les principales brèches de sécurité applicative. Découvrez comment les sécuriser efficacement.
Un projet cybersécurité ? Parlons-en.
Pentest, conformité NIS 2, ISO 27001, audit IA, RSSI externalisé… nos experts répondent sous 24h pour évaluer votre besoin et vous proposer un accompagnement sur mesure.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Laisser un commentaire