






Le MTTD mesure le délai entre le début d'un incident et sa détection. Définition, calcul, différences avec MTTA et MTTR, benchmarks 2020-2026 et méthode de réduction.
Le MTTD (Mean Time To Detect, ou temps moyen de détection) mesure le délai moyen qui sépare le début d'une activité malveillante de sa détection par l'équipe de sécurité. Autrement dit, il chiffre la durée pendant laquelle un attaquant agit sans être vu. Les données publiées en 2026 rappellent l'enjeu : le rapport IBM Cost of a Data Breach estime à 183 jours le temps moyen d'identification d'une violation de données, Mandiant relève une présence médiane des attaquants de 14 jours dans ses investigations, et CrowdStrike observe un mouvement latéral en 29 minutes en moyenne chez les cybercriminels. Ce guide donne une définition sans ambiguïté du MTTD, le distingue du MTTA, du MTTR et du dwell time, propose une méthode de calcul reproductible avec une requête KQL, compare les benchmarks 2020-2026, y compris pour le cloud et le SaaS, puis détaille les leviers concrets de réduction. Il complète notre guide pratique pour construire un SOC en 2026.
Résumé exécutif : Le MTTD n'a de valeur que si ses bornes sont définies : début de l'activité malveillante d'un côté, création de l'alerte ou de l'incident de l'autre. Calculé sur les seuls vrais positifs, segmenté par gravité et publié avec sa médiane et son 90e percentile, il devient un outil de pilotage fiable. Les benchmarks publics mesurent des choses différentes et ne remplacent pas une mesure interne. La réduction du temps de détection passe d'abord par la couverture des journaux, la qualité des règles et des tests réguliers en conditions maîtrisées.
Points clés de cet article :
- Écrivez la définition de chaque horodatage (T0 à T6) avant de publier le moindre chiffre de MTTD, MTTA ou MTTR.
- Publiez la médiane et le 90e percentile à côté de la moyenne : quelques intrusions longues suffisent à déformer un temps moyen.
- Suivez le taux de détection interne en parallèle du MTTD, car un incident signalé par un tiers révèle une détection manquée.
- Mesurez la latence d'ingestion des sources cloud et SaaS, une cause fréquente et souvent ignorée d'un temps de détection élevé.
- Validez le MTTD par des exercices purple team horodatés, technique par technique, plutôt que par la seule statistique des incidents réels.
MTTD : définition du Mean Time To Detect
Le MTTD est un indicateur de performance opérationnelle permettant de mesurer la rapidité avec laquelle un centre opérationnel de sécurité (SOC) repère une menace active. Il se calcule comme la moyenne, sur une période donnée, des écarts entre le début d'un incident et sa détection. Plus il est faible, plus la fenêtre d'action laissée à l'attaquant se réduit avant toute réaction défensive.
MTTD (Mean Time To Detect) : temps moyen écoulé entre le début d'une activité malveillante dans le système d'information et le moment où cette activité est détectée, c'est-à-dire transformée en alerte ou en incident qualifiable par l'équipe de sécurité. On l'exprime en minutes pour les menaces automatisées et en heures ou en jours pour les intrusions.
Le temps moyen de détection ne doit pas être confondu avec la latence technique d'un outil. Le délai entre l'écriture d'un journal et son indexation dans le SIEM (Security Information and Event Management) n'est qu'une composante du MTTD. De même, le temps de qualification par un analyste relève d'un autre indicateur, le MTTA, qui commence précisément là où la détection s'arrête.
Cet indicateur compte parce que chaque heure non détectée profite à l'attaquant : élévation de privilèges, mouvement latéral, exfiltration ou préparation d'un chiffrement. Un délai de détection court ne garantit pas l'absence de dommages, mais il conditionne tout le reste de la chaîne de réponse. Un confinement rapide reste impossible tant que l'incident n'a pas été vu.
Dans un tableau de bord, le MTTD est un indicateur de performance du dispositif de détection, pas un indicateur de risque. Transformé en seuil d'alerte pour le comité des risques, il change de nature et relève d'une démarche de gouvernance distincte. Cet article reste sur le terrain opérationnel : définir, mesurer, comparer et réduire le temps de détection d'un SOC interne ou externalisé.
Les horodatages qui bornent la mesure du temps de détection
Un MTTD n'est comparable d'un mois à l'autre que si ses bornes restent identiques. En pratique, une même intrusion produit plusieurs horodatages successifs, et chaque équipe choisit, souvent sans l'écrire, celui qui marque le début et la fin. La première étape consiste donc à nommer ces instants et à documenter leur source dans l'outil de gestion des incidents.
- T0, début de l'activité malveillante : compromission initiale ou première action de l'attaquant, généralement établie après coup par l'investigation.
- T1, premier événement journalisé : trace exploitable produite par un poste, un serveur, un équipement réseau ou un service cloud.
- T2, ingestion : arrivée de cet événement dans le SIEM ou la plateforme XDR, après collecte et normalisation.
- T3, détection : création de l'alerte ou de l'incident par une règle, un modèle comportemental ou un chasseur de menaces.
- T4, prise en charge : premier analyste qui s'attribue l'incident et commence la qualification.
- T5, confinement : isolement du poste, révocation des sessions ou blocage qui stoppe la progression.
- T6, résolution : éradication, remédiation et clôture documentée de l'incident.
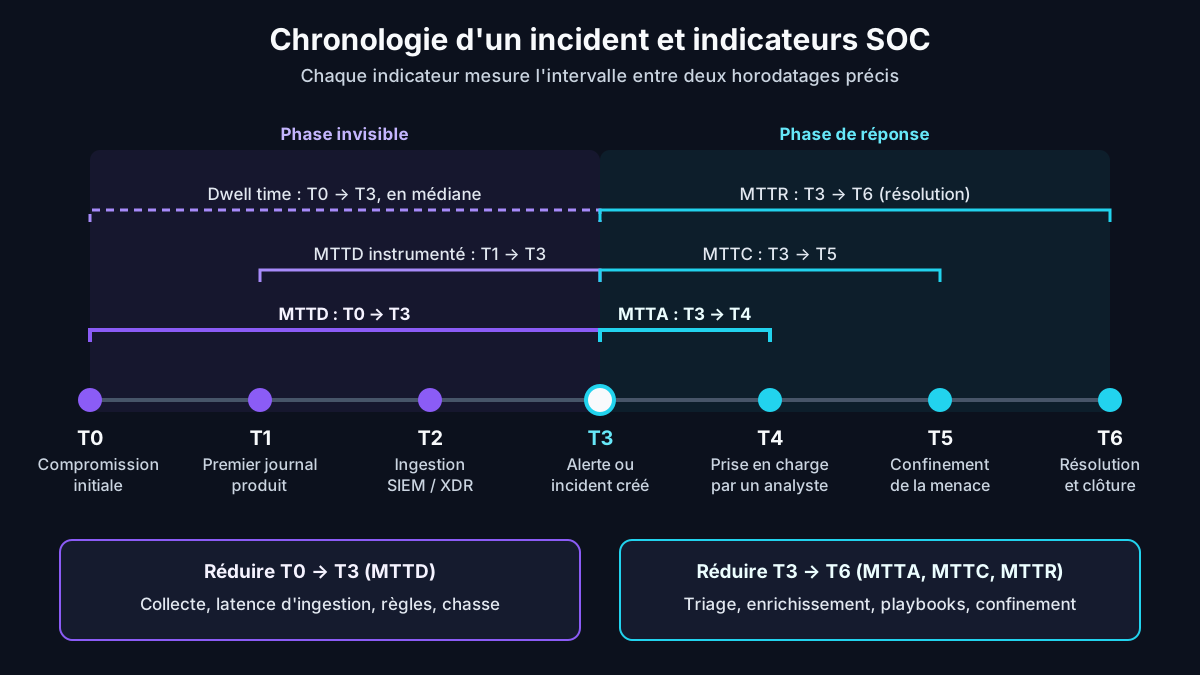
Avec ces repères, le MTTD correspond à la moyenne de T3 moins T0. Lorsque T0 reste inconnu, de nombreuses équipes calculent T3 moins T1, que l'on peut appeler MTTD instrumenté : il mesure la réactivité des règles sur les traces disponibles, mais ignore le temps passé par l'attaquant avant la première trace collectée. Les deux valeurs sont utiles à condition de ne jamais les mélanger.
La synchronisation des horloges conditionne la justesse de ces écarts. Des équipements non synchronisés par NTP, des fuseaux horaires mélangés ou des journaux horodatés à l'arrivée plutôt qu'à la source produisent des écarts négatifs ou artificiellement longs. Normaliser tous les horodatages en UTC dès la collecte évite la plupart de ces erreurs et facilite les comparaisons entre outils.
MTTD, MTTA, MTTR, MTTC et dwell time : bien distinguer les indicateurs SOC
Le MTTD appartient à une famille d'indicateurs temporels qui découpent le cycle de vie d'un incident. Chacun répond à une question différente et relève d'un propriétaire différent : ingénierie de détection, analystes de niveau 1, équipe de réponse à incident. Les confondre conduit à des comparaisons trompeuses, notamment avec les prestataires de services de sécurité managés.
| Indicateur | Intervalle mesuré | Question posée | Piège fréquent |
|---|---|---|---|
| MTTD (Mean Time To Detect) | T0 ou T1 → T3 | Combien de temps la menace reste-t-elle invisible ? | Démarrer au premier journal sans le préciser |
| MTTA (Mean Time To Acknowledge) | T3 → T4 | Combien de temps une alerte attend-elle un analyste ? | Compter une prise en charge automatique comme humaine |
| MTTC (Mean Time To Contain) | T3 → T5 | Combien de temps faut-il pour stopper la progression ? | Confondre confinement et éradication |
| MTTR (Respond, Remediate ou Resolve) | T3 → T5 ou T3 → T6 | Combien de temps faut-il pour traiter l'incident ? | Ne pas préciser quelle variante est mesurée |
| Dwell time | T0 → T3, en médiane | Combien de jours l'attaquant reste-t-il présent avant découverte ? | Le comparer à un MTTD en minutes |
| MTTI (Mean Time To Identify) | T0 → identification de la violation | Combien de temps faut-il pour reconnaître une violation de données ? | Oublier qu'il provient d'enquêtes déclaratives |
Le MTTA, charnière entre détection et réponse
Le MTTA (Mean Time To Acknowledge) mesure l'attente d'une alerte avant qu'un analyste ne la prenne en charge. Il dépend de la volumétrie, de la qualité des règles et de l'organisation des équipes, notamment la nuit et le week-end. Un MTTA qui dérive signale souvent une file saturée par des faux positifs, un problème que traite notre article sur le triage, la classification et la priorisation des incidents.
MTTR : un acronyme, plusieurs définitions
L'acronyme MTTR recouvre au moins trois réalités : temps de réponse jusqu'à la première action de confinement, temps de remédiation jusqu'à la correction de la cause, ou temps de résolution jusqu'à la clôture. Un prestataire peut afficher un excellent MTTR de réponse tout en laissant des incidents ouverts pendant des semaines. Le contrat, comme le tableau de bord, doit nommer la variante mesurée.
Dwell time et MTTI : les cousins des rapports publics
Le dwell time, ou durée de présence, compte le nombre de jours pendant lesquels un attaquant opère avant d'être découvert ; Mandiant le publie en médiane à partir de ses investigations. Le MTTI d'IBM mesure le temps moyen d'identification d'une violation de données. Ces deux grandeurs sont proches du MTTD par leurs bornes, mais elles portent sur des populations et des méthodes de collecte très différentes.
Comment calculer le MTTD : formule, médiane et percentiles
La formule de base est simple : MTTD = somme des délais de détection (T3 − T0) divisée par le nombre d'incidents retenus sur la période. La difficulté tient au choix de la population. Il faut retenir les vrais positifs confirmés, exclure les tests et les exercices, puis décider si les incidents détectés par un tiers entrent dans le calcul ou font l'objet d'un indicateur séparé.
Prenons un exemple fictif de cinq incidents confirmés sur un trimestre, détectés après 2 heures, 3 heures, 4 heures, 6 heures et 30 jours. La moyenne atteint 147 heures, soit un peu plus de six jours, alors que la médiane reste à 4 heures. Une seule intrusion longue suffit à transformer un SOC réactif en SOC lent dans le tableau de bord, d'où l'intérêt de publier plusieurs statistiques.
- Moyenne : utile pour suivre une tendance longue, mais très sensible aux valeurs extrêmes.
- Médiane : reflète l'expérience typique et résiste aux intrusions exceptionnelles.
- 90e percentile : révèle la queue de distribution, c'est-à-dire les incidents que le dispositif détecte mal.
- Taux de détection interne : part des incidents découverts par le SOC plutôt que par un client, un partenaire ou l'attaquant lui-même.
La segmentation rend l'indicateur actionnable. Un MTTD global mélange des alertes antivirus détectées en quelques minutes et des compromissions d'identité découvertes en semaines. Il est préférable de le calculer par niveau de gravité, par source de détection (EDR, SIEM, chasse, notification externe) et par tactique MITRE ATT&CK, afin de savoir précisément où investir.
La période de calcul doit enfin rester stable. Une fenêtre glissante de 90 jours lisse les variations sans masquer les tendances, tandis qu'un calcul mensuel sur une dizaine d'incidents produit surtout du bruit statistique. Lorsque l'échantillon est trop faible, mieux vaut présenter la liste des incidents et leurs délais individuels qu'une moyenne qui ne signifie rien.
Mesurer le MTTD dans un SIEM : exemple avec Microsoft Sentinel
Les SIEM modernes stockent déjà les horodatages nécessaires. Dans Microsoft Sentinel, la table SecurityIncident expose notamment l'heure de la première activité de l'incident, l'heure de création, la première modification et la date de clôture, comme le détaille la référence Microsoft Learn de la table SecurityIncident. Ces colonnes suffisent pour une première mesure.
// MTTD instrumenté, MTTA et MTTR de résolution sur 90 jours, par gravité
SecurityIncident
| where TimeGenerated > ago(90d)
| summarize arg_max(TimeGenerated, *) by IncidentNumber   // dernier état connu
| where Status == "Closed" and Classification == "TruePositive"
| extend TTD_min = datetime_diff('minute', CreatedTime, FirstActivityTime),
         TTA_min = datetime_diff('minute', FirstModifiedTime, CreatedTime),
         TTR_min = datetime_diff('minute', ClosedTime, CreatedTime)
| summarize Incidents = count(),
            MTTD_moy = round(avg(TTD_min), 1),
            MTTD_med = percentile(TTD_min, 50),
            MTTD_p90 = percentile(TTD_min, 90),
            MTTA_moy = round(avg(TTA_min), 1),
            MTTR_moy = round(avg(TTR_min), 1)
          by Severity
| order by Severity asc
Cette requête retient le dernier état de chaque incident, car la table conserve une ligne par mise à jour. Elle calcule ensuite trois délais en minutes, puis les agrège par gravité avec la moyenne, la médiane et le 90e percentile. Le filtre sur la classification exclut les faux positifs et les incidents bénins, qui fausseraient la mesure de performance.
Le résultat reste un MTTD instrumenté. La première activité correspond au plus ancien événement rattaché aux alertes de l'incident, pas à la compromission initiale reconstituée par l'enquête. Pour obtenir un MTTD complet, ajoutez un champ personnalisé, par exemple une étiquette contenant la date de compromission établie lors de l'investigation, et renseignez-le systématiquement avant la clôture.
La première modification de l'incident ne reflète pas toujours une action humaine : une règle d'automatisation qui change la gravité ou ajoute une étiquette la déclenche aussi. Pour un MTTA fiable, préférez l'horodatage d'attribution à un analyste nommé. La même logique se transpose sur Wazuh en mode SIEM et XDR ou sur Elastic Security, à partir des horodatages d'alertes et de dossiers.
Environnement de test : lab isolé composé d'un espace de travail Log Analytics de test relié à Microsoft Sentinel, d'un serveur Wazuh 4.x sur Debian 12 et d'une pile Elastic 8.x, collectant les journaux de Windows Server 2022, de postes Windows 11 et d'un tenant Microsoft 365 de démonstration. Les incidents sont générés par des scénarios d'émulation horodatés ; les requêtes et la méthode décrites ici visent la reproductibilité du calcul, non la publication de valeurs de référence.
Benchmarks MTTD et MTTR 2020-2026 : la série IBM et le dwell time Mandiant
Les benchmarks publics servent de repère, pas d'objectif. Ils reposent sur des méthodologies distinctes : enquête déclarative auprès d'organisations victimes pour IBM et le Ponemon Institute, analyse d'investigations de réponse à incident pour Mandiant, télémétrie d'une plateforme de sécurité pour CrowdStrike. Leurs chiffres racontent tous la même tension entre vitesse de l'attaquant et lenteur de la découverte.
247 jours : temps moyen d'identification (183 jours) puis de confinement (64 jours) d'une violation de données dans l'édition 2026 du Cost of a Data Breach Report d'IBM, publiée en juillet 2026 et portant sur 602 organisations touchées entre mars 2025 et février 2026.
14 jours : durée médiane de présence des attaquants avant détection dans les investigations menées en 2025, contre 11 jours l'année précédente, selon le rapport M-Trends 2026 de Mandiant, publié le 23 mars 2026.
| Édition | MTTI | MTTC | Cycle total |
|---|---|---|---|
| 2020 | 207 | 73 | 280 |
| 2021 | 212 | 75 | 287 |
| 2022 | 207 | 70 | 277 |
| 2023 | 204 | 73 | 277 |
| 2024 | 194 | 64 | 258 |
| 2025 | 181 | 60 | 241 |
| 2026 | 183 | 64 | 247 |
La série IBM montre une baisse quasi continue du cycle total entre les éditions 2021 et 2025, puis une légère remontée en 2026, que le rapport présente comme la fin de cinq années de recul. Les années correspondent à l'année de publication, pas à celle des violations. Le rapport associe aussi les cycles de plus de 200 jours à un coût moyen de 5,65 millions de dollars, contre 4,32 millions pour les cycles plus courts.
Origine de la détection et vitesse des attaquants : les enseignements de 2026
Le temps de détection, ou MTTD (Mean Time To Detect), dépend fortement de l'acteur qui découvre l'incident. Selon IBM, les équipes internes ont identifié 38 % des violations étudiées en 2026, les prestataires de services de sécurité managés 31 % et les tiers 14 %. Le cycle complet atteint 209 jours lorsque l'équipe interne détecte, 230 jours avec un prestataire et 280 jours lorsqu'un tiers alerte l'organisation. Côté Mandiant, la détection interne progresse à 52 % des cas en 2025, contre 43 % en 2024.
L'automatisation réduit nettement les délais dans l'échantillon IBM : les organisations qui utilisent largement l'intelligence artificielle et l'automatisation en sécurité affichent un cycle de 215 jours, contre 280 jours pour celles qui ne les utilisent pas. Cet écart de 65 jours reste une corrélation observée dans une enquête, pas une promesse applicable à n'importe quel SOC.
À l'autre extrémité de l'échelle de temps, le Global Threat Report 2026 de CrowdStrike indique que le temps moyen de propagation des cybercriminels, entre l'accès initial et le mouvement latéral, est tombé à 29 minutes en 2025, le cas le plus rapide n'ayant pris que 27 secondes. Comparé à un temps de détection exprimé en jours, cet ordre de grandeur montre pourquoi chaque heure compte.
MTTD en environnement cloud et SaaS : des angles morts spécifiques
Le cloud ne raccourcit pas mécaniquement le temps de détection. Dans l'édition 2026 du rapport IBM, les violations touchant des données en cloud privé ont été identifiées et confinées en 240 jours en moyenne, celles sur site en 244 jours, et celles réparties entre plusieurs environnements en 256 jours. La dispersion des données reste le facteur le plus pénalisant pour la visibilité.
Le rapport M-Trends 2026 décrit des attaquants qui contournent les défenses SaaS en récupérant des jetons OAuth à longue durée de vie et des cookies de session, souvent après une ingénierie sociale par téléphone visant le support informatique. Ces accès ressemblent à une activité légitime : sans journaux d'audit d'identité et sans règles comportementales, le délai de détection s'allonge, parfois jusqu'à une notification externe.
Mandiant signale aussi des intrusions d'espionnage sur des équipements de bordure dépourvus d'EDR, avec des durées de présence proches de 400 jours pour la porte dérobée BRICKSTORM. Une rétention des journaux limitée à 90 jours rend alors impossible la reconstitution du point d'entrée. Pour le calcul du MTTD, cela signifie que T0 reste inconnu et que le délai calculé sous-estime la réalité.
Le modèle de responsabilité partagée complique encore la mesure. La publication NIST SP 800-61 Rev. 3, publiée en avril 2025, rappelle qu'un fournisseur de services peut détecter une activité malveillante plus tôt grâce à la corrélation entre ses clients, et que les flux d'information doivent être définis contractuellement. Un incident détecté par l'hébergeur doit donc être horodaté au moment de sa notification.
Pour réduire le temps de détection en environnement cloud et SaaS, quelques sources prioritaires font la différence :
- journaux de connexion et d'audit du fournisseur d'identité, y compris les consentements d'applications OAuth ;
- journaux d'activité du plan de contrôle cloud, comme les créations de clés, de rôles ou de règles réseau ;
- journaux d'audit des suites SaaS critiques, en vérifiant la latence réelle de livraison de chaque API ;
- journaux d'audit Kubernetes et des chaînes de déploiement lorsque des charges conteneurisées sont exposées ;
- journaux d'administration des équipements de bordure, VPN et pare-feu, conservés au-delà de 90 jours.
Les biais qui faussent le MTTD
Le premier biais est un biais de survie : le MTTD ne porte que sur les incidents détectés. Une intrusion jamais découverte n'entre pas dans la moyenne, si bien qu'un dispositif aveugle peut afficher un excellent temps de détection. C'est pourquoi le taux de détection interne et les tests en conditions maîtrisées doivent toujours accompagner l'indicateur.
Le deuxième biais tient à la reconstitution de T0. Une investigation sommaire place souvent le début de l'incident au premier événement visible, ce qui raccourcit artificiellement le délai. À l'inverse, une investigation approfondie qui remonte de plusieurs mois dégrade brutalement la statistique. Documenter le niveau de confiance de la date de compromission évite des interprétations erronées.
Le troisième biais est organisationnel. Dès qu'un MTTD devient un objectif individuel, il incite à ouvrir des incidents prématurés, à clôturer vite ou à requalifier les cas gênants. Un indicateur de temps de détection ne doit jamais servir à évaluer un analyste : il mesure un système composé de sources, de règles, d'outils et de processus.
D'autres sources d'erreur sont plus techniques : horloges non synchronisées, fuseaux horaires mélangés, incidents fusionnés dont la première activité remonte à une alerte ancienne, règles d'automatisation qui modifient les horodatages, ou mélange de gravités dans une même moyenne. Un contrôle trimestriel d'un échantillon d'incidents, horodatage par horodatage, permet de repérer ces dérives avant qu'elles n'atteignent le comité de direction.
Réduire le MTTD : sources, latence et règles de détection
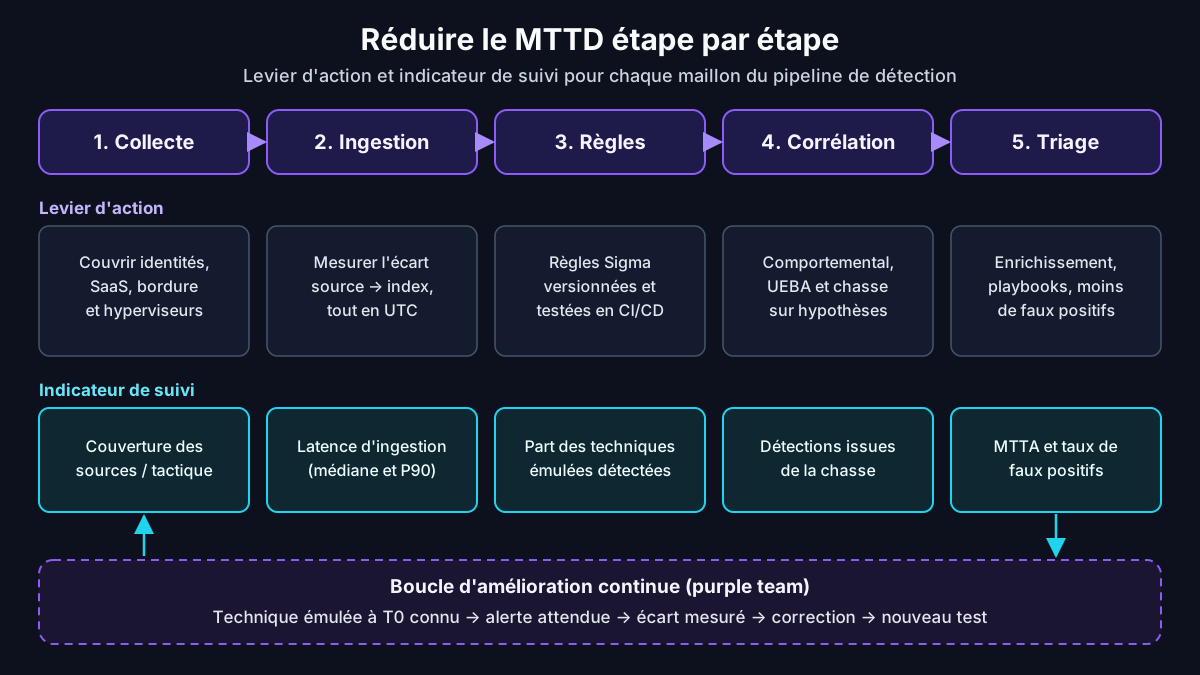
Réduire le temps moyen de détection revient à agir sur chaque maillon de la chaîne, de la production du journal jusqu'à la création de l'alerte. Les gains les plus importants viennent rarement d'un nouvel outil : ils proviennent d'une meilleure couverture des sources, d'une latence maîtrisée et de règles testées sur les techniques qui comptent vraiment pour l'organisation.
Couvrir les bonnes sources de journaux
Aucune règle ne détecte ce qui n'est pas collecté. Une cartographie des sources par tactique MITRE ATT&CK révèle vite les zones aveugles : équipements de bordure, identités, applications SaaS, hyperviseurs. Prioriser ces sources selon les scénarios de menace de l'organisation produit souvent un gain plus net que l'ajout de règles sur des journaux déjà bien couverts.
Mesurer et réduire la latence d'ingestion
La latence entre T1 et T2 est un angle mort fréquent des tableaux de bord. Calculer, pour chaque source, l'écart entre l'horodatage d'origine et l'heure d'indexation permet d'identifier les connecteurs lents, les files d'attente saturées ou les API SaaS qui livrent leurs événements par lots. Cet écart doit figurer dans le tableau de bord, à côté du MTTD.
Écrire, tester et versionner les règles
Des règles écrites en Sigma, format générique traduisible vers la plupart des SIEM, facilitent la couverture des techniques prioritaires ; notre guide d'écriture des règles Sigma détaille la méthode. Les intégrer dans une chaîne detection-as-code garantit qu'une règle modifiée reste testée et qu'une régression du MTTD se voit avant la production.
Le catalogue de départ compte autant que la méthode. Les cas d'usage SIEM essentiels fournissent une base de règles éprouvées, à adapter au contexte plutôt qu'à importer en bloc. Une règle trop bruyante allonge le MTTA et finit souvent par être désactivée, ce qui dégrade à terme le temps de détection qu'elle devait améliorer.
Détection comportementale et chasse aux menaces : réduire la queue de distribution
Les intrusions les plus longues à découvrir, celles qui gonflent le 90e percentile du MTTD, échappent souvent aux règles fondées sur des signatures. Elles empruntent des comptes valides, des outils d'administration légitimes ou des équipements sans agent de sécurité. Pour les atteindre, il faut compléter les règles par des approches comportementales et par une chasse aux menaces organisée.
Les indicateurs de compromission statiques vieillissent vite face à des infrastructures changeantes et des maliciels en mémoire. Mandiant recommande en 2026 de privilégier des modèles comportementaux qui signalent les écarts à une base de référence, notamment sur les accès aux équipements de bordure et l'usage des jetons d'intégration SaaS. La chasse aux menaces, enfin, détecte ce que les règles ignorent encore.
Une chasse efficace part d'une hypothèse écrite, par exemple l'usage anormal d'un jeton OAuth ou une connexion d'administration hors des plages habituelles, puis l'éprouve sur les journaux disponibles. Chaque chasse fructueuse doit se conclure par une nouvelle règle ou par l'enrichissement d'une règle existante : c'est ainsi que la découverte manuelle d'aujourd'hui devient la détection automatique de demain.
Conseil d'expert : pour chaque incident confirmé dont le délai de détection dépasse votre 90e percentile, ouvrez une fiche d'amélioration avec trois questions : la trace existait-elle, était-elle collectée à temps, une règle aurait-elle dû la signaler ? Cette revue systématique transforme les pires incidents en backlog d'ingénierie de détection et fait baisser le MTTD bien plus sûrement qu'un objectif chiffré imposé à l'équipe.
Réduire le MTTA et le MTTR sans sacrifier la qualité
Une détection rapide ne sert à rien si l'alerte attend des heures dans une file. Le MTTA dépend d'abord du rapport signal sur bruit : moins de faux positifs, c'est plus d'attention pour les vraies menaces. L'enrichissement automatique des alertes avec le contexte de l'actif, de l'utilisateur et du renseignement sur la menace réduit ensuite le temps de qualification de chaque cas.
La priorisation doit suivre la vitesse de l'adversaire. Mandiant observe qu'en 2025 le délai médian entre un accès initial et sa transmission à un second groupe criminel est tombé à 22 secondes, contre plus de 8 heures en 2022. Le rapport recommande donc de traiter certaines alertes de maliciel jugées mineures comme des signaux précurseurs d'une intrusion interactive.
Pour le MTTC et le MTTR, les gains viennent des actions de confinement préautorisées : isolement d'un poste par l'EDR, révocation des sessions et des jetons, désactivation d'un compte à privilèges. La publication NIST SP 800-61 Rev. 3 cite les playbooks comme un moyen de documenter ces procédures, à exercer périodiquement, afin qu'elles s'exécutent sans attendre une décision prise dans l'urgence.
L'automatisation ne doit pas dégrader la qualité de l'investigation. Un incident clôturé vite mais mal qualifié risque de resurgir plus tard, avec un T0 plus ancien et un coût supérieur. Mesurer le taux de réouverture des incidents et le taux de faux négatifs découverts par la chasse permet de vérifier que la baisse des délais ne se fait pas au détriment de la justesse des décisions.
Piloter le MTTD : objectifs chiffrés et contrats de service
Fixer un objectif de MTTD sans référence interne revient à choisir un chiffre au hasard. Une démarche robuste part de la mesure actuelle, segmentée par gravité, puis définit des cibles progressives pour la médiane et le 90e percentile. L'objectif le plus utile porte sur la réduction de la queue de distribution, c'est-à-dire des incidents les plus longs à détecter.
Une cible bien formulée combine un délai et une proportion, par gravité : une part donnée des incidents critiques détectée sous un délai fixé, une autre pour les incidents élevés, et ainsi de suite. Cette forme, inspirée des objectifs de niveau de service, résiste mieux aux valeurs extrêmes qu'une moyenne et rend visible la progression sur les incidents difficiles, ceux qui pèsent le plus sur le risque.
Les contrats avec un prestataire de SOC managé doivent préciser les bornes de chaque délai. Un engagement de détection en quinze minutes, par exemple, commence-t-il à l'événement source, à l'ingestion ou à la création de l'alerte ? Sans cette précision, deux prestataires annonçant le même délai ne promettent pas la même chose, et la comparaison des offres devient trompeuse.
Temps de détection, NIS 2 et reporting de direction
La réglementation européenne donne une raison supplémentaire de réduire le temps moyen de détection (MTTD). L'article 23 de la directive NIS 2 impose aux entités essentielles et importantes une alerte précoce dans les 24 heures après avoir eu connaissance d'un incident important, puis une notification dans les 72 heures. Le délai réglementaire court à partir de la prise de connaissance, pas de la compromission : un MTTD long retarde l'ensemble de la chaîne.
Dans le reporting, le temps de détection gagne à être présenté avec ses compagnons : MTTA (temps moyen de prise en charge), MTTC (temps moyen de confinement), taux de détection interne, couverture des techniques prioritaires et latence d'ingestion. Notre article sur les métriques DevSecOps et KPI de maturité propose une logique comparable pour relier indicateurs techniques et décisions de pilotage. La NIST SP 800-61 Rev. 3 range d'ailleurs les mesures de performance parmi les éléments habituels d'une politique de réponse aux incidents.
Tester son MTTD en conditions maîtrisées : purple team et émulation
Les incidents réels sont trop rares et trop hétérogènes pour mesurer finement le temps de détection d'une technique donnée. L'émulation d'adversaire en purple team résout ce problème : l'équipe offensive exécute une technique à un instant précisément connu, l'équipe défensive observe si et quand l'alerte apparaît. T0 devient alors un fait, et non une estimation.
Avertissement : les exercices d'émulation d'adversaire ne doivent être menés que sur des systèmes dont vous avez la responsabilité, dans un périmètre écrit et validé par la direction, avec des outils reconnus et des scénarios réversibles. Cet article décrit une démarche de mesure défensive et ne fournit aucun mode opératoire d'attaque.
- Sélectionner les techniques MITRE ATT&CK prioritaires au regard des menaces pesant sur l'organisation.
- Rédiger le périmètre, les autorisations, les plages horaires et les critères d'arrêt de l'exercice.
- Exécuter chaque test avec un horodatage précis en UTC, consigné dans un journal d'exercice.
- Relever pour chaque technique l'heure de l'alerte, son absence ou sa gravité inadéquate.
- Corriger la collecte ou la règle, puis rejouer le test pour confirmer le gain, idéalement dans la chaîne de détection-as-code.
Des cadres ouverts comme Atomic Red Team ou MITRE Caldera facilitent ces exercices, à condition de les adapter au contexte et de ne pas viser la seule exhaustivité. Le résultat attendu est une matrice qui associe, à chaque technique testée, un statut de détection et un délai mesuré. Rejouée chaque trimestre, cette matrice devient la preuve la plus solide de l'évolution du MTTD.
Retour terrain : Cas typique rencontré en mission — en purple team, je fais exécuter une sélection resserrée de techniques prioritaires, horodatées à la seconde près. Au premier passage, seule une minorité déclenche une alerte exploitable ; d'autres sont détectées avec plusieurs heures de retard, parce que la règle tourne en recherche planifiée ou que la source arrive par lots. Avant le second passage, l'équipe active les journaux manquants, convertit ces recherches en détections quasi temps réel et relève la gravité des alertes noyées. Le gain mesuré convainc mieux qu'un rapport.
Retour terrain : Cas typique rencontré en mission — le MTTD présenté au comité de direction part souvent du premier journal collecté et s'arrête à la qualification dans l'outil de tickets. Recalculé depuis le début réel de l'attaque, établi par les reconstitutions forensiques, jusqu'à la création de l'alerte, il passe de quelques heures à plusieurs jours sur les incidents graves. La direction arbitre alors en faveur de nouvelles sources de journaux et d'une conservation allongée, et le tableau de bord affiche désormais les deux valeurs, explicitement nommées.
À lire aussi : des tests Atomic Red Team pour mesurer la détection ; les indicateurs clés de risque (KRI).
Questions fréquentes
Qu'est-ce que le MTTD en cybersécurité ?
Le MTTD, pour Mean Time To Detect, désigne le temps moyen qui s'écoule entre le début d'une activité malveillante et sa détection par l'équipe de sécurité. Il se calcule sur les incidents confirmés d'une période, en faisant la moyenne des écarts entre la date de début de l'incident et la création de l'alerte ou de l'incident. Il indique combien de temps un attaquant peut agir sans être repéré. Pour être exploitable, il doit s'accompagner d'une définition écrite de ses bornes, d'une segmentation par gravité et de statistiques complémentaires comme la médiane et le 90e percentile. C'est un indicateur de performance du dispositif de détection dans son ensemble, et non une mesure du travail individuel des analystes.
Quelle est la différence entre MTTD et MTTR ?
Le MTTD mesure le temps nécessaire pour détecter une menace, tandis que le MTTR mesure le temps nécessaire pour la traiter une fois détectée. Le premier s'arrête à la création de l'alerte ou de l'incident ; le second commence à ce moment-là. Attention : MTTR peut signifier temps de réponse jusqu'au confinement, temps de remédiation ou temps de résolution jusqu'à la clôture, selon les organisations. Un tableau de bord ou un contrat de service doit donc préciser la variante retenue. Entre les deux se place souvent le MTTA, qui mesure l'attente avant prise en charge par un analyste. Suivre ces trois délais ensemble permet de savoir si un incident long s'explique par une détection tardive, une file d'attente saturée ou une réponse lente.
Comment calculer le MTTD d'un SOC ?
Sélectionnez d'abord les incidents confirmés de la période, en excluant faux positifs, tests et exercices. Pour chacun, calculez l'écart entre la date de début de l'activité malveillante et la date de création de l'alerte. Faites ensuite la somme de ces écarts et divisez-la par le nombre d'incidents. Si la date de compromission n'est pas connue, utilisez le premier événement journalisé et signalez qu'il s'agit d'un MTTD instrumenté. Dans un SIEM comme Microsoft Sentinel, une requête KQL sur la table SecurityIncident suffit pour automatiser le calcul. Publiez enfin la médiane et le 90e percentile à côté de la moyenne, et segmentez par gravité et par source de détection, afin d'éviter qu'une seule intrusion longue ne masque la réalité.
Quel est un bon MTTD pour un SOC ?
Il n'existe pas de valeur universelle, car le bon niveau dépend du type de menace, de la gravité et du périmètre surveillé. Une alerte de maliciel sur un poste doit être détectée en minutes, alors qu'une compromission d'identité discrète peut demander des jours d'analyse. Les benchmarks publics donnent des ordres de grandeur : IBM mesure 183 jours d'identification moyenne en 2026, Mandiant une présence médiane des attaquants de 14 jours. Face à un mouvement latéral moyen de 29 minutes observé par CrowdStrike, l'objectif réaliste consiste à réduire progressivement la médiane et surtout le 90e percentile de votre propre mesure, technique par technique, plutôt qu'à viser un chiffre emprunté à un rapport.
Quelle différence entre MTTD et dwell time ?
Les deux mesurent le temps pendant lequel un attaquant reste invisible, mais pas de la même façon. Le dwell time, popularisé par Mandiant, compte le nombre de jours de présence d'un attaquant avant sa découverte et se publie généralement en médiane, à partir d'investigations de réponse à incident. Le MTTD est un indicateur interne au SOC, calculé en moyenne sur tous les incidents confirmés, y compris les menaces automatisées détectées en quelques minutes. Le dwell time sert surtout à comparer des tendances globales d'une année sur l'autre ; le MTTD sert à piloter un dispositif de détection précis. Comparer directement les deux chiffres conduit presque toujours à des conclusions erronées, car leurs populations diffèrent.
Conclusion
Le MTTD est l'indicateur qui révèle combien de temps une organisation reste aveugle face à un attaquant. Bien défini, borné par des horodatages documentés, calculé sur les vrais positifs et accompagné de sa médiane, de son 90e percentile et du taux de détection interne, il devient un levier de pilotage puissant. Les benchmarks 2020-2026 montrent des progrès réels mais fragiles, alors que les attaquants gagnent encore en vitesse. Pour l'intégrer dans une organisation de détection cohérente, appuyez-vous sur notre guide pour construire un SOC.
Votre temps de détection reflète-t-il la réalité ?
Ayi NEDJIMI accompagne les équipes SOC et les RSSI dans la définition de leurs indicateurs MTTD, MTTA et MTTR, l'audit de leur couverture de détection et l'organisation d'exercices purple team horodatés pour mesurer et réduire leur temps de détection.
Faire évaluer votre dispositif de détectionÀ propos de l'auteur

Ayi NEDJIMI
Auditeur Senior Cybersécurité & Consultant IA
Expert Judiciaire — Cour d'Appel de Paris
Habilitation Confidentiel Défense
ayi@ayinedjimi-consultants.fr
Ayi NEDJIMI est un vétéran de la cybersécurité avec plus de 25 ans d'expérience sur des missions critiques. Ancien développeur Microsoft à Redmond sur le module GINA (Windows NT4) et co-auteur de la version française du guide de sécurité Windows NT4 pour la NSA.
À la tête d'Ayi NEDJIMI Consultants, il réalise des audits Lead Auditor ISO 42001 et ISO 27001, des pentests d'infrastructures critiques, du forensics et des missions de conformité NIS2 / AI Act.
Conférencier international (Europe & US), il a formé plus de 10 000 professionnels.
Domaines d'expertise
Ressources & Outils de l'auteur
Articles connexes
Event ID 4769 : lire l'événement et détecter le Kerberoasting
L'event ID 4769 trace chaque ticket de service Kerberos émis par un contrôleur de domaine. Champs, codes, fin du RC4 en 2026 et requêtes pour détecter le Kerberoasting.
Atomic Red Team : tester et valider sa détection SOC en 2026
Guide 2026 d’Atomic Red Team : format des tests, Invoke-AtomicRedTeam, laboratoire sûr, priorisation ATT&CK et boucle de validation de la détection en SOC.
VirusTotal API 2026 : Automatiser l'Analyse de Fichiers et Menaces
Guide complet de l'API VirusTotal v3 : scripts Python pour analyser hashes, URLs et IPs, automatisation SOC avec rate limiting, enrichissement d'alertes SIEM et intégration SOAR.
Un projet cybersécurité ? Parlons-en.
Pentest, conformité NIS 2, ISO 27001, audit IA, RSSI externalisé… nos experts répondent sous 24h pour évaluer votre besoin et vous proposer un accompagnement sur mesure.
Commentaires
Aucun commentaire pour le moment. Soyez le premier à commenter !
Laisser un commentaire